تنظيف وتجهيز البيانات لـ Data Science والذكاء الاصطناعي
تنظيف وتجهيز البيانات لـ Data Science والذكاء الاصطناعي
وصف الخدمة
هل لديك بيانات خام تحتاج لتنظيفها وتجهيزها لمشاريع علوم البيانات (Data Science) والذكاء الاصطناعي؟
أقدم خدمة معالجة البيانات (Data Preprocessing) باستخدام لغة Python باحترافية لضمان دقة وجاهزية بياناتك.
تشمل الخدمة الأساسية:
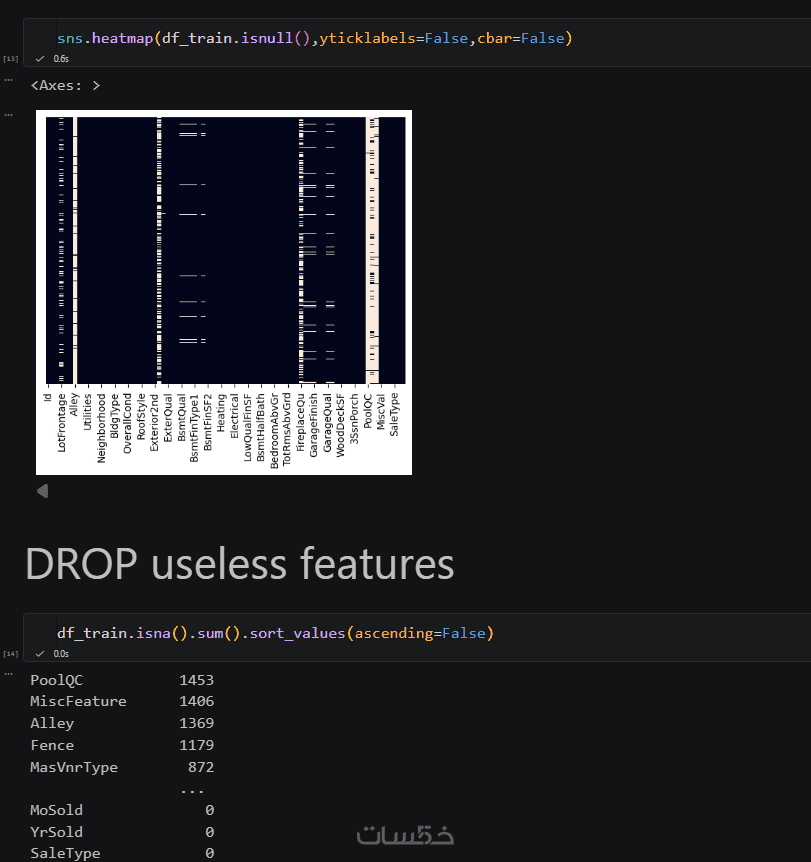
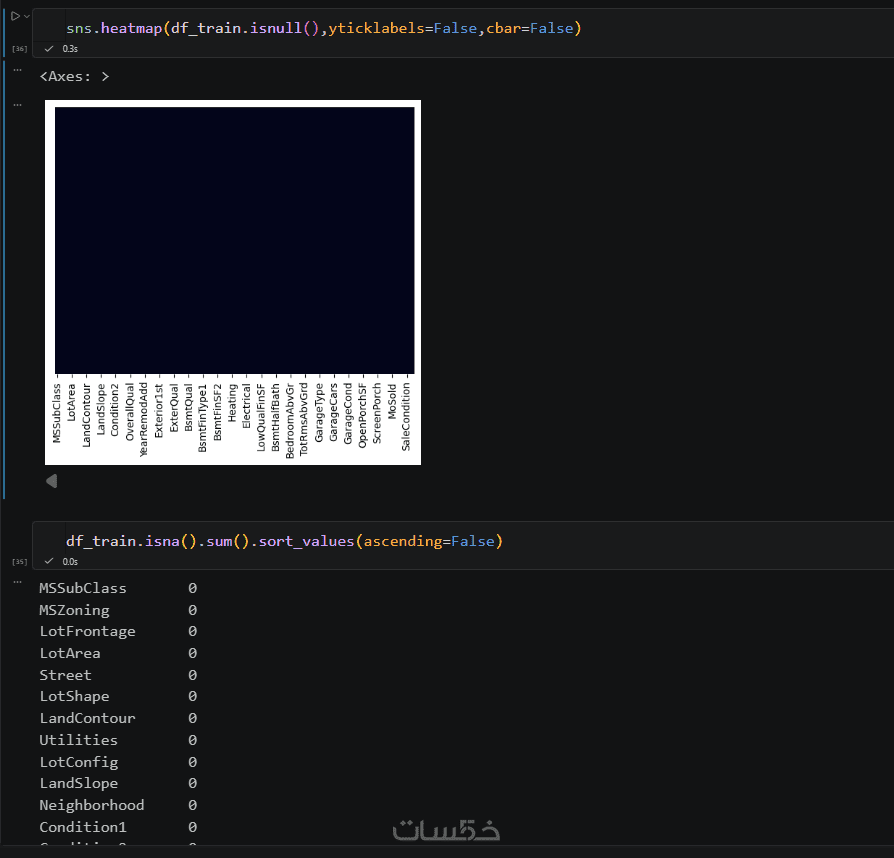
تنظيف البيانات بمكتبة Pandas (معالجة القيم المفقودة Imputation، إزالة التكرار، وتعديل الأنواع).
معالجة ملف واحد (جدول أو جدولين بحد أقصى 2000 صف).
ترميز البيانات (Categorical Encoding) وتهيئتها لتدريب نماذج الذكاء الاصطناعي.
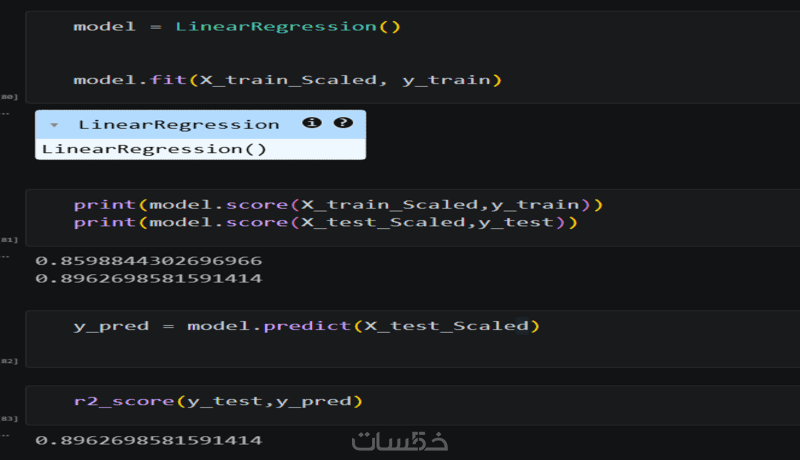
تسليم البيانات بصيغة (CSV/Excel) مع ملف الكود (.ipynb) موثق بالتعليقات.
(لأحجام أكبر، أو تحليل EDA معقد، أو Feature Scaling، يرجى مراجعة تطويرات الخدمة).
ما أحتاجه للبدء:
ملفات البيانات الخام (CSV, Excel, JSON).
توضيح الهدف (تحليل أم تدريب نموذج Machine Learning).
أي متطلبات خاصة بالمعالجة إن وجدت.
مميزات الخدمة
دقة ومراجعة
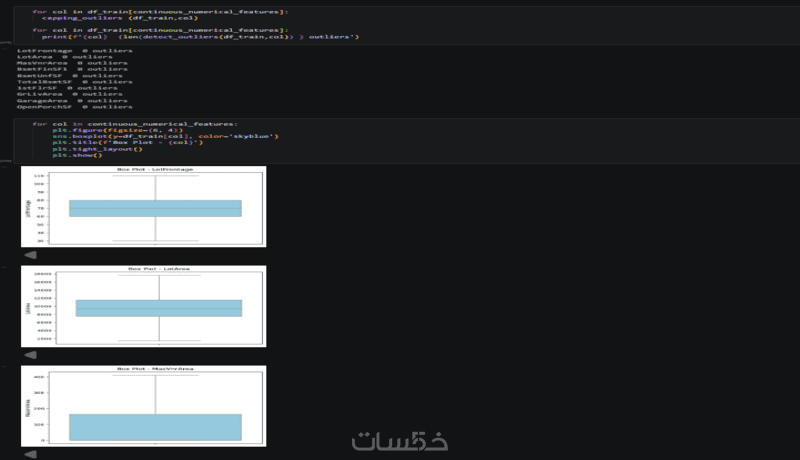
تتم مراجعة دقيقة للبيانات (Data Cleaning) والتأكد من خلوها من الأخطاء والقيم الشاذة (Outliers) قبل التسليم.
تواصل أثناء التنفيذ
أطلعك على أي ملاحظة، قيم مفقودة (Missing Values)، أو شذوذ في البيانات (Outliers) أثناء مرحلة الـ Preprocessing وقبل تسليم البيانات النهائية.
التزام بالموعد
تسليم العمل النهائي في المدة المتفق عليها بدقة.
خصوصية بياناتك
لا أشارك بياناتك مع أي طرف، وأقوم بحذف جميع ملفات البيانات (Datasets) فور انتهاء الطلب. (مهم جداً للبيانات المالية أو بيانات العملاء).
ما الذي ستستلمه
ملف البيانات المنظفة (CSV/Excel) والكود المصدري (.ipynb)
ملف بيانات معالج وجاهز تماماً لعمليات التحليل أو الـ Machine Learning. مبني على بيانات لا تتجاوز جدول أو جدولين بحد أقصى (2000) صف، بدون هندسة ميزات (Feature Engineering) معقدة للخدمة الأساسية.
كلمات مفتاحية
خدمات قد تنال إعجابك


طلب الخدمة
سعر الخدمة
$5.00
خدمات قد تنال إعجابك
كلمات مفتاحية