تطوير وبناء نماذج تعلم آلة Machine Learning مخصصة بدقة
تطوير وبناء نماذج تعلم آلة Machine Learning مخصصة بدقة
وصف الخدمة
هل ترغب في تحويل بياناتك إلى تنبؤات ذكية وقرارات مبنية على البيانات؟
أقدم خدمة بناء وتطوير نماذج تعلم الآلة (Machine Learning) باستخدام Python، بدايةً من معالجة البيانات وحتى تدريب النموذج وتقييم أدائه، مع اختيار الخوارزميات المناسبة لمشكلتك.
تشمل الخدمة الأساسية:
- بناء نموذج تصنيف (Classification) أو تنبؤ (Regression).
- استخدام خوارزميات مثل Random Forest وSVM وLogistic Regression.
- معالجة وتجهيز البيانات (Data Preprocessing).
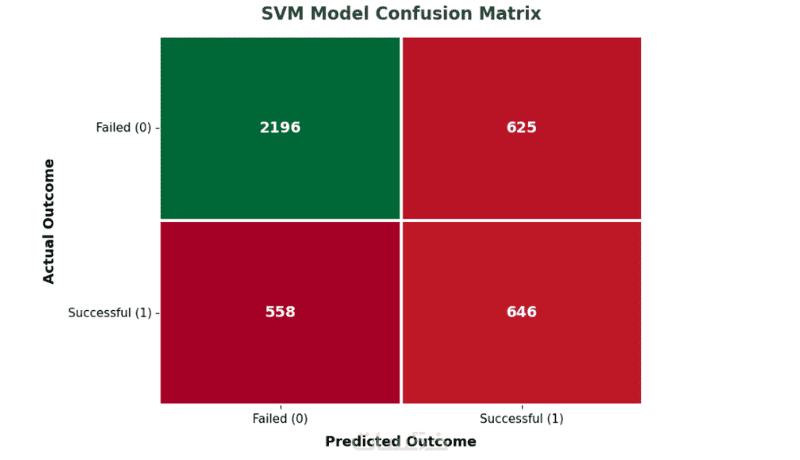
- تقييم الأداء باستخدام Accuracy وF1-Score وRMSE.
- تسليم ملخص بنتائج النموذج.
حدود الخدمة:
حتى 10,000 صف و20 عمودًا.
إضافات اختيارية:
- نماذج Deep Learning باستخدام PyTorch.
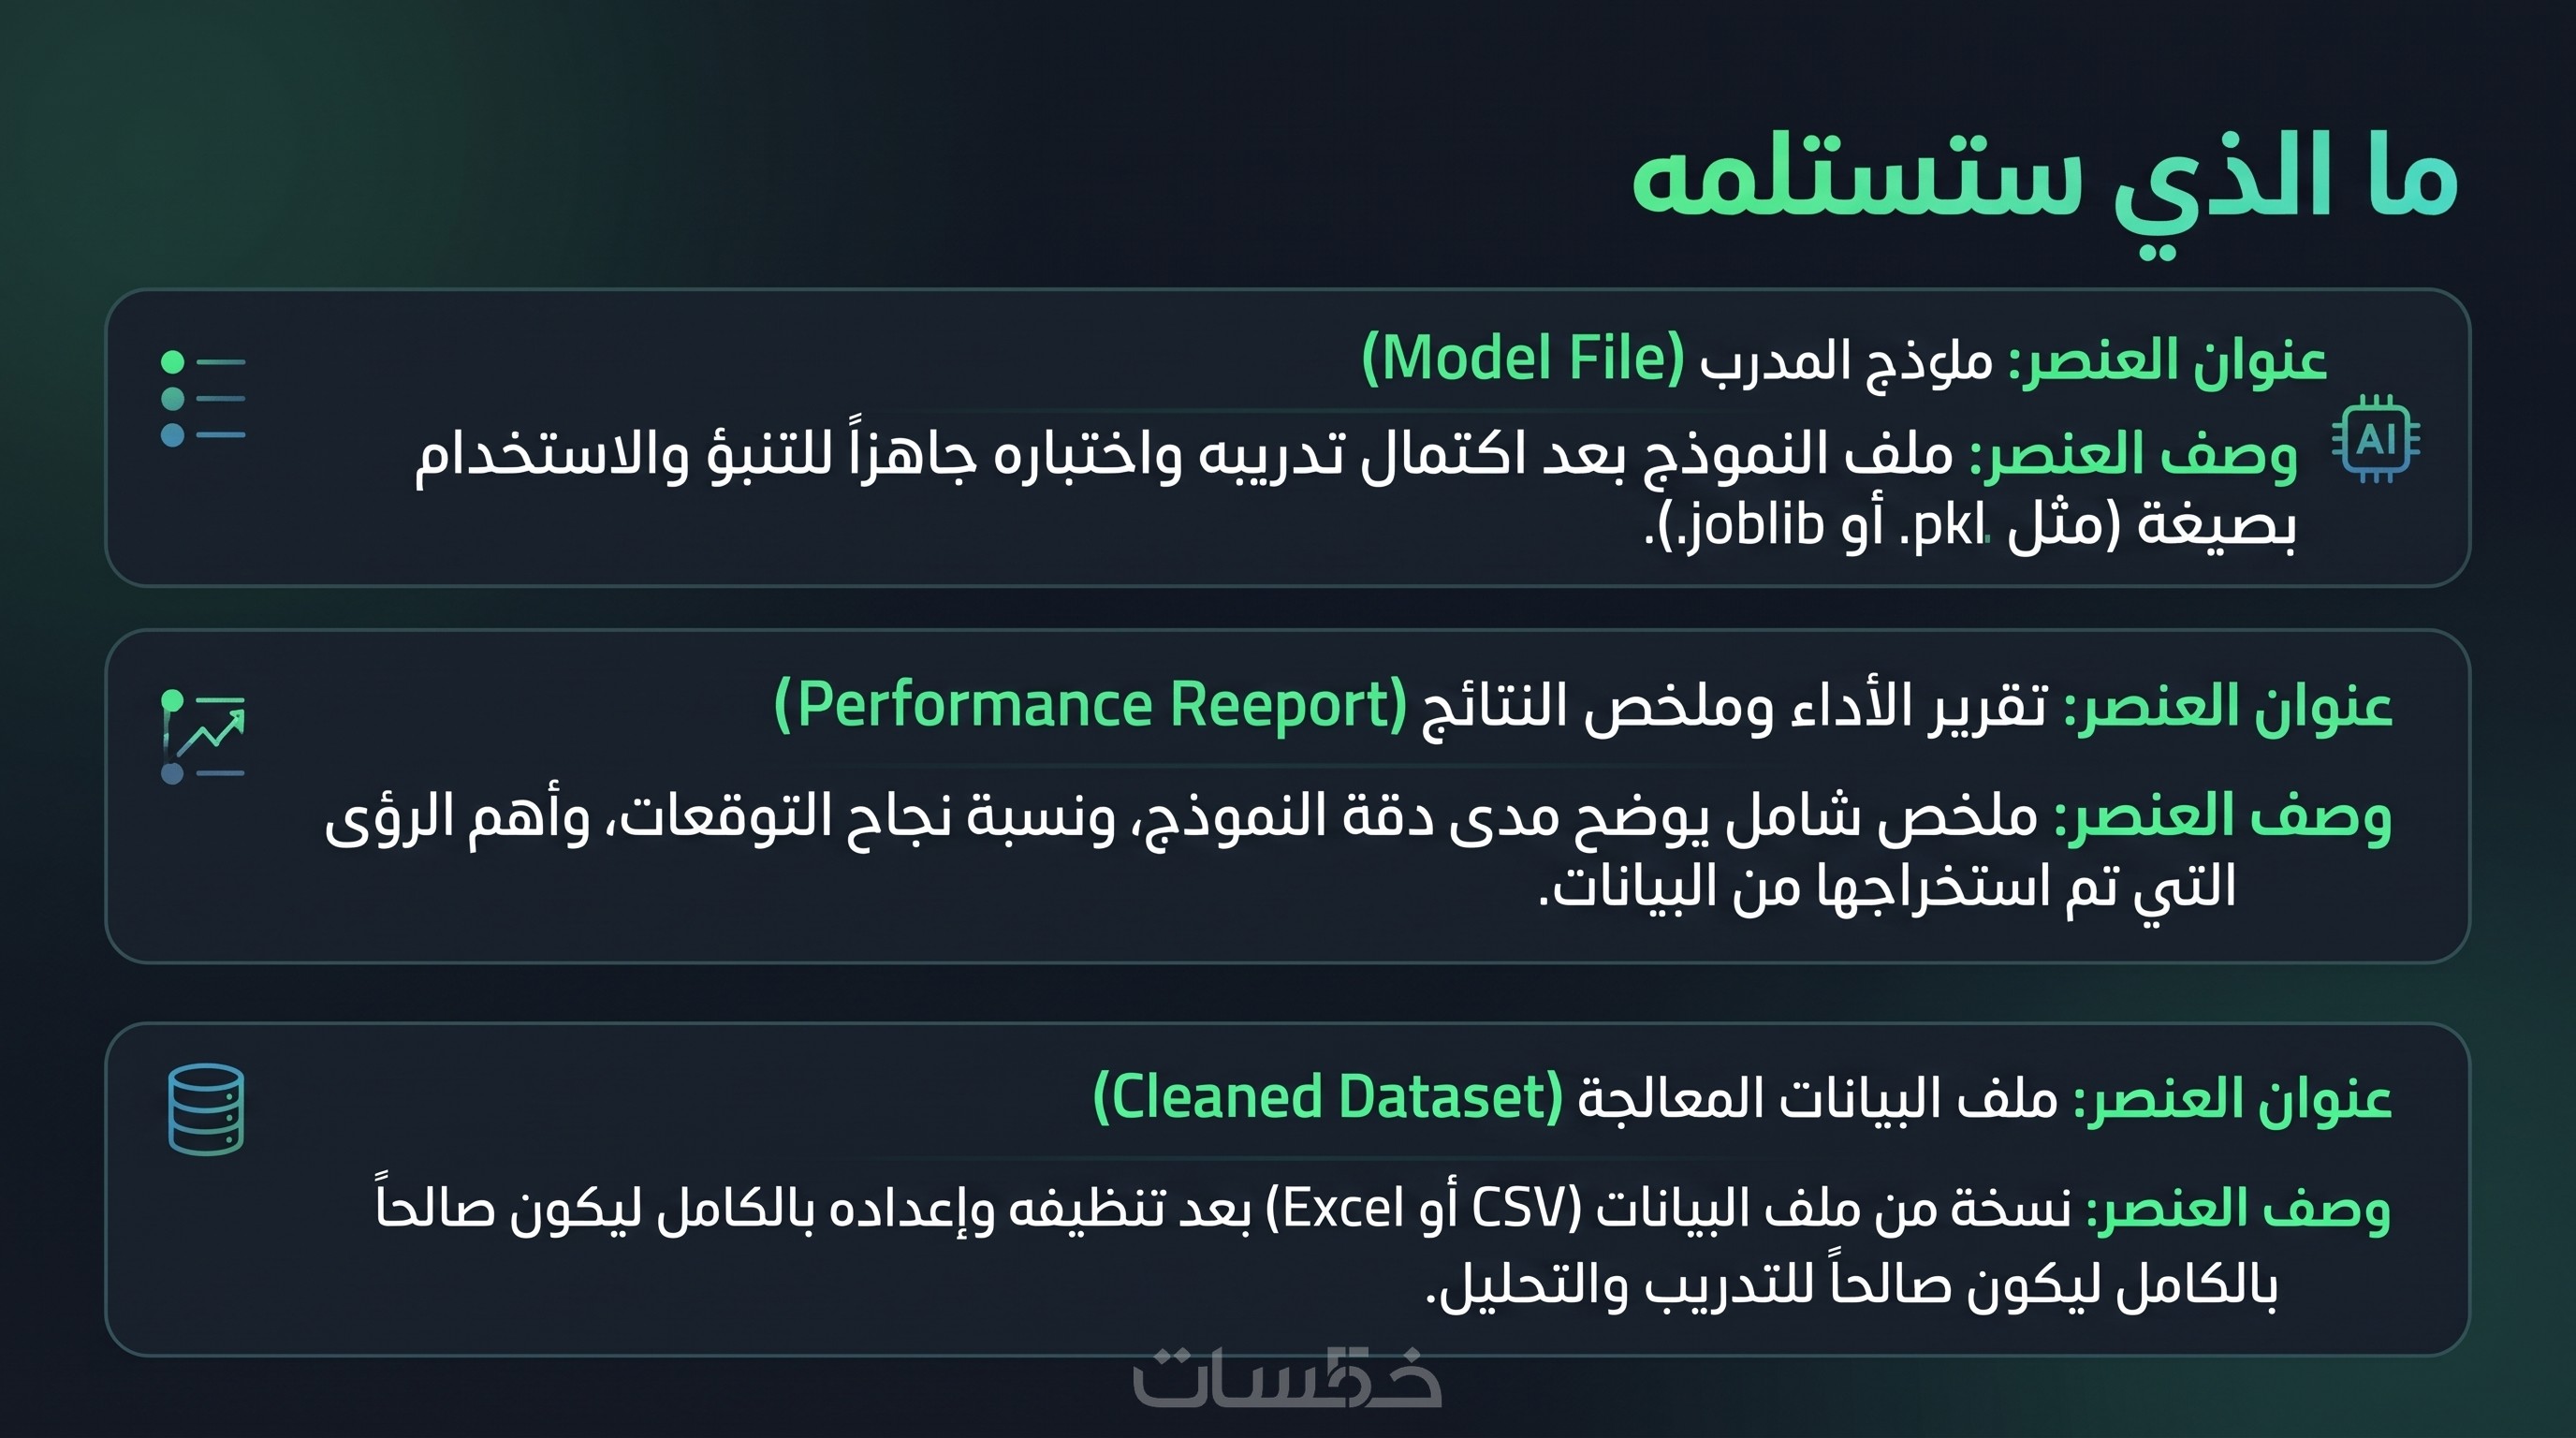
- تحسين النماذج باستخدام Hyperparameter Tuning.
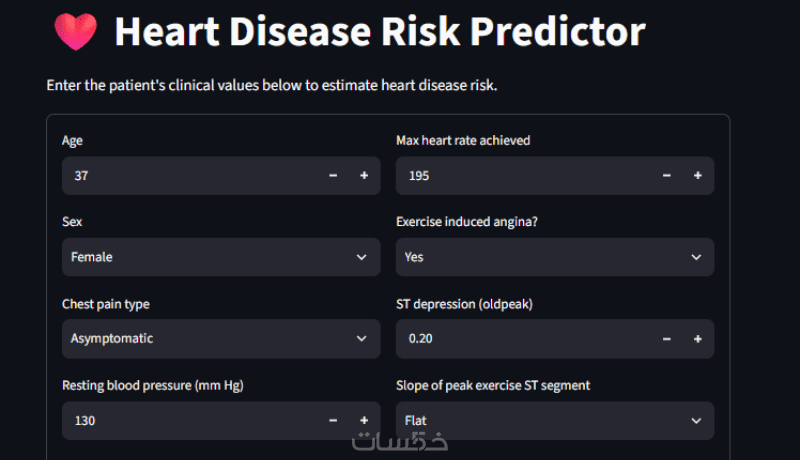
- إنشاء واجهة تفاعلية باستخدام Streamlit.
- تسليم الكود المصدري بصيغة Python أو Jupyter Notebook.
مميزات الخدمة
فهم المتطلبات وتحديد الهدف.
مناقشة أهداف المشروع وتحليل طبيعة البيانات لضمان اختيار الحل البرمجي والرياضي الأمثل.
تنظيف ومعالجة البيانات.
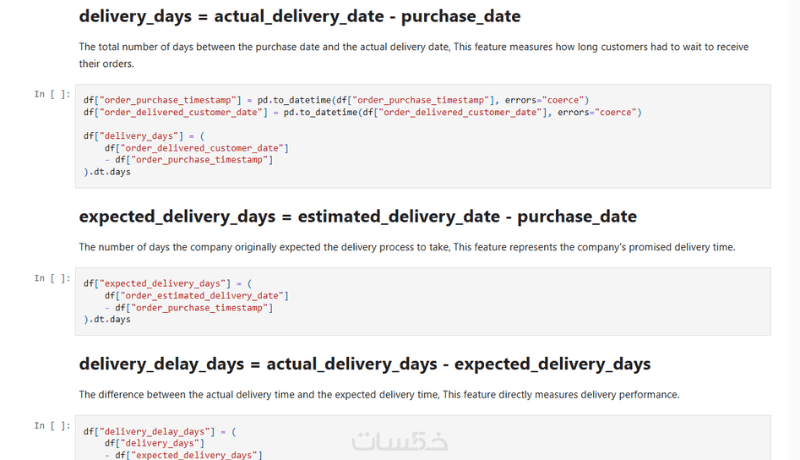
التعامل مع القيم المفقودة، إزالة التكرارات، وتجهيز البيانات (Data Preprocessing) لتلائم تدريب النموذج.
التحليل الاستكشافي (EDA).
استخراج الأنماط والعلاقات المهمة بين المتغيرات وتوضيحها بيانيًا لفهم سلوك البيانات بشكل أعمق.
اختيار الخوارزمية المناسبة.
تحديد أفضل خوارزميات تعلم الآلة (تصنيف Classification أو انحدار Regression) بناءً على المشكلة.
بناء وتدريب النموذج.
تدريب نموذج الذكاء الاصطناعي على البيانات المعالجة باستخدام مكتبات بايثون الحديثة مثل Scikit-Learn.
تقييم الأداء والاختبار.
اختبار دقة النموذج باستخدام مقاييس إحصائية دقيقة (مثل Accuracy و RMSE) لضمان كفاءة النتائج.
التسليم والتوثيق.
تسليم الكود المصدري منظمًا وموثقًا خطوة بخطوة لتسهيل قراءته، مع ملخص يوضح نتائج الأداء.
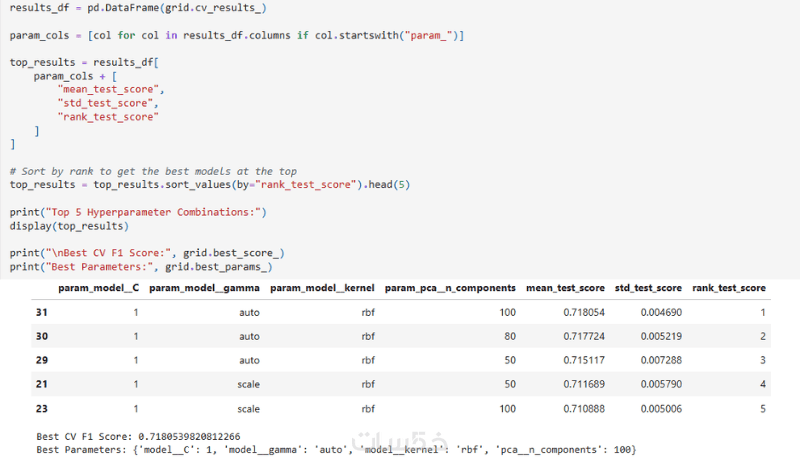
ما الذي ستستلمه
ملف النموذج المدرب (Model File).
ملف النموذج بعد اكتمال تدريبه واختباره جاهزًا للتنبؤ والاستخدام بصيغة (مثل .pkl أو .joblib).
تقرير الأداء وملخص النتائج (Performance Report).
ملخص شامل يوضح مدى دقة النموذج، ونسبة نجاح التوقعات، وأهم الرؤى التي تم استخراجها من البيانات.
ملف البيانات المعالجة (Cleaned Dataset).
نسخة من ملف البيانات (CSV أو Excel) بعد تنظيفه وإعداده بالكامل (Data Preprocessing) ليكون صالحاً للتدريب والتحليل.
كلمات مفتاحية
خدمات قد تنال إعجابك


طلب الخدمة
سعر الخدمة
$15.00
خدمات قد تنال إعجابك
كلمات مفتاحية