بناء أنظمة ذكاء اصطناعي متكاملة End-to-End ML
بناء أنظمة ذكاء اصطناعي متكاملة End-to-End ML
إيه اللي هبنية لك في نظام الـ End-to-End؟
معالجة البيانات وهندستها (Data Pipeline & Feature Engineering):
إعداد وتنظيف البيانات الخام وإبناء خط معالجة تلقائي (Automated Data Pipeline).
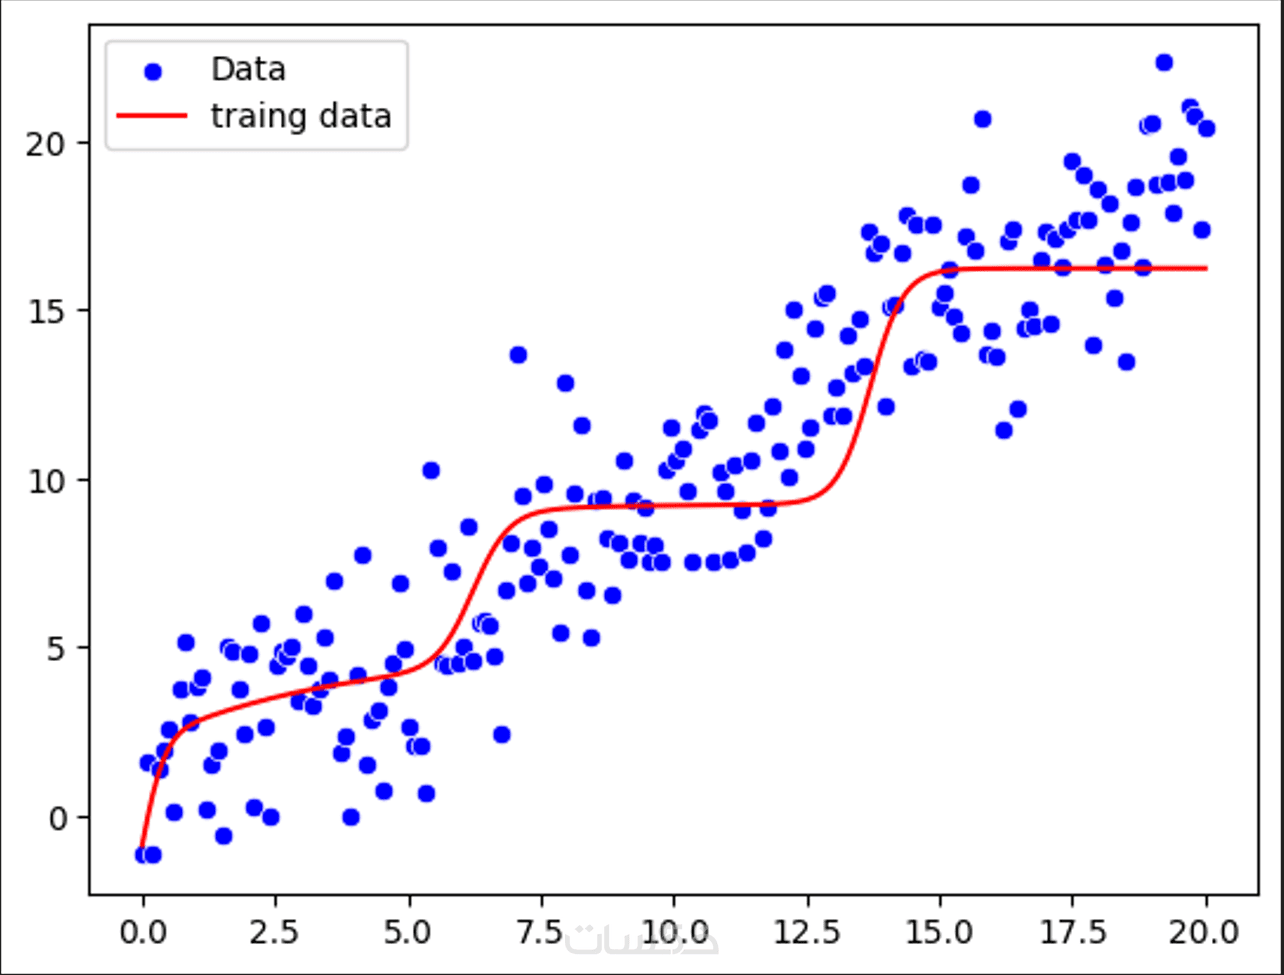
تدريب النموذج وضبط الأداء (Model Training & Optimization):
استخدام الخوارزميات المناسبة (زي XGBoost, LightGBM, Random Forest, أو PyTorch) للحصول على أفضل دقة.
ضبط المعلمات (Hyperparameter Tuning) واختبار النموذج بدقة.
واجهة المستخدم أو الـ API (Deployment & Integration):
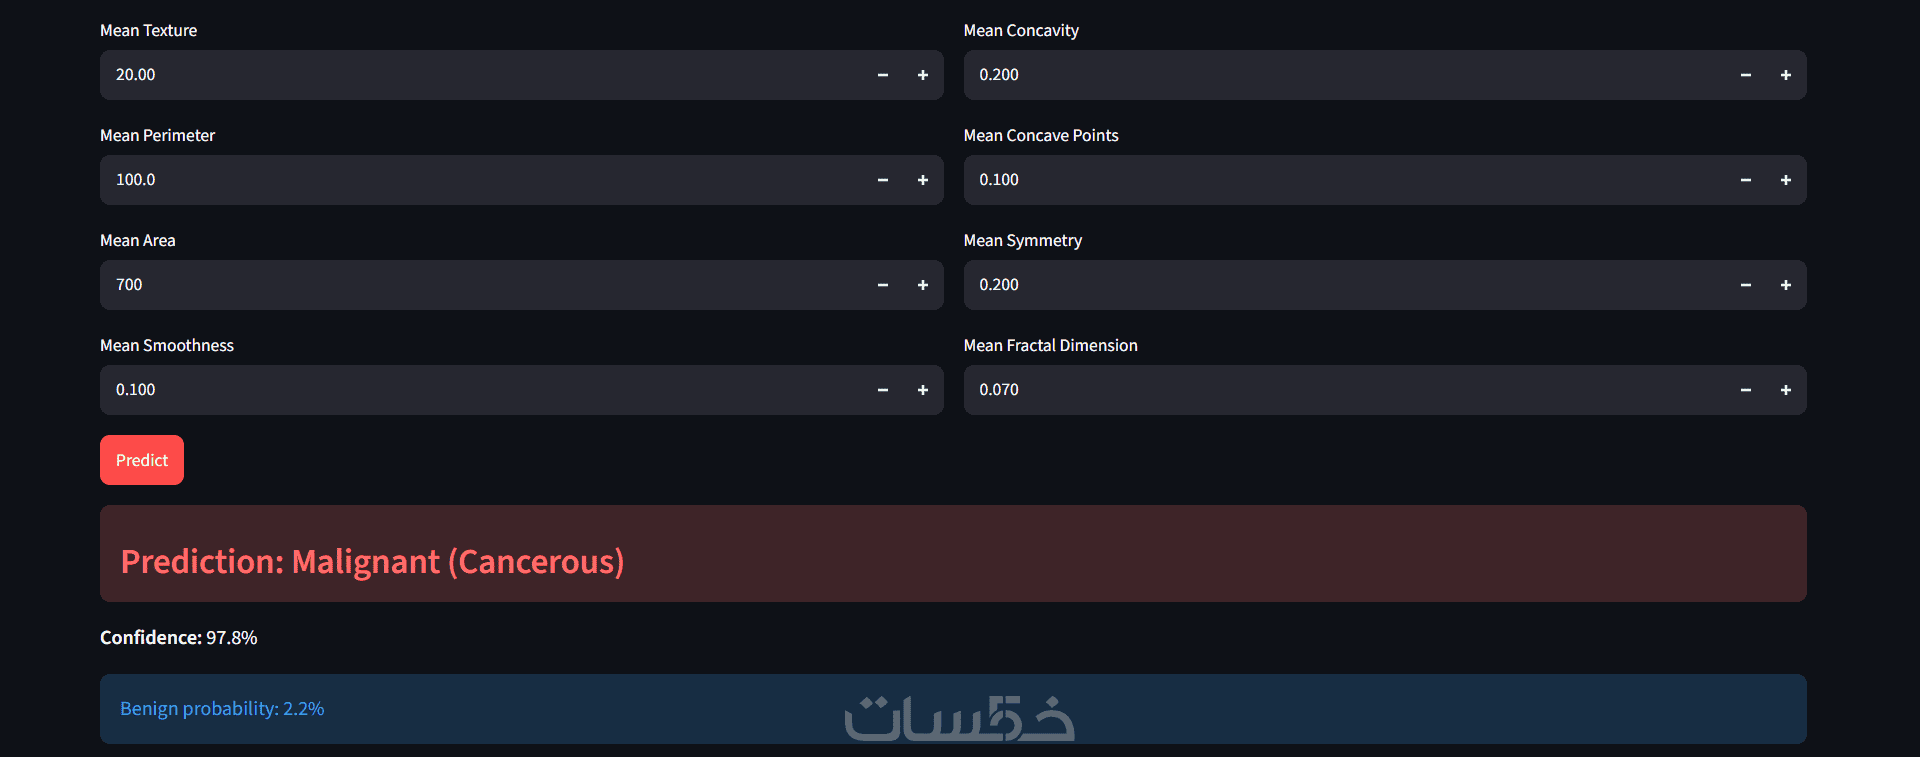
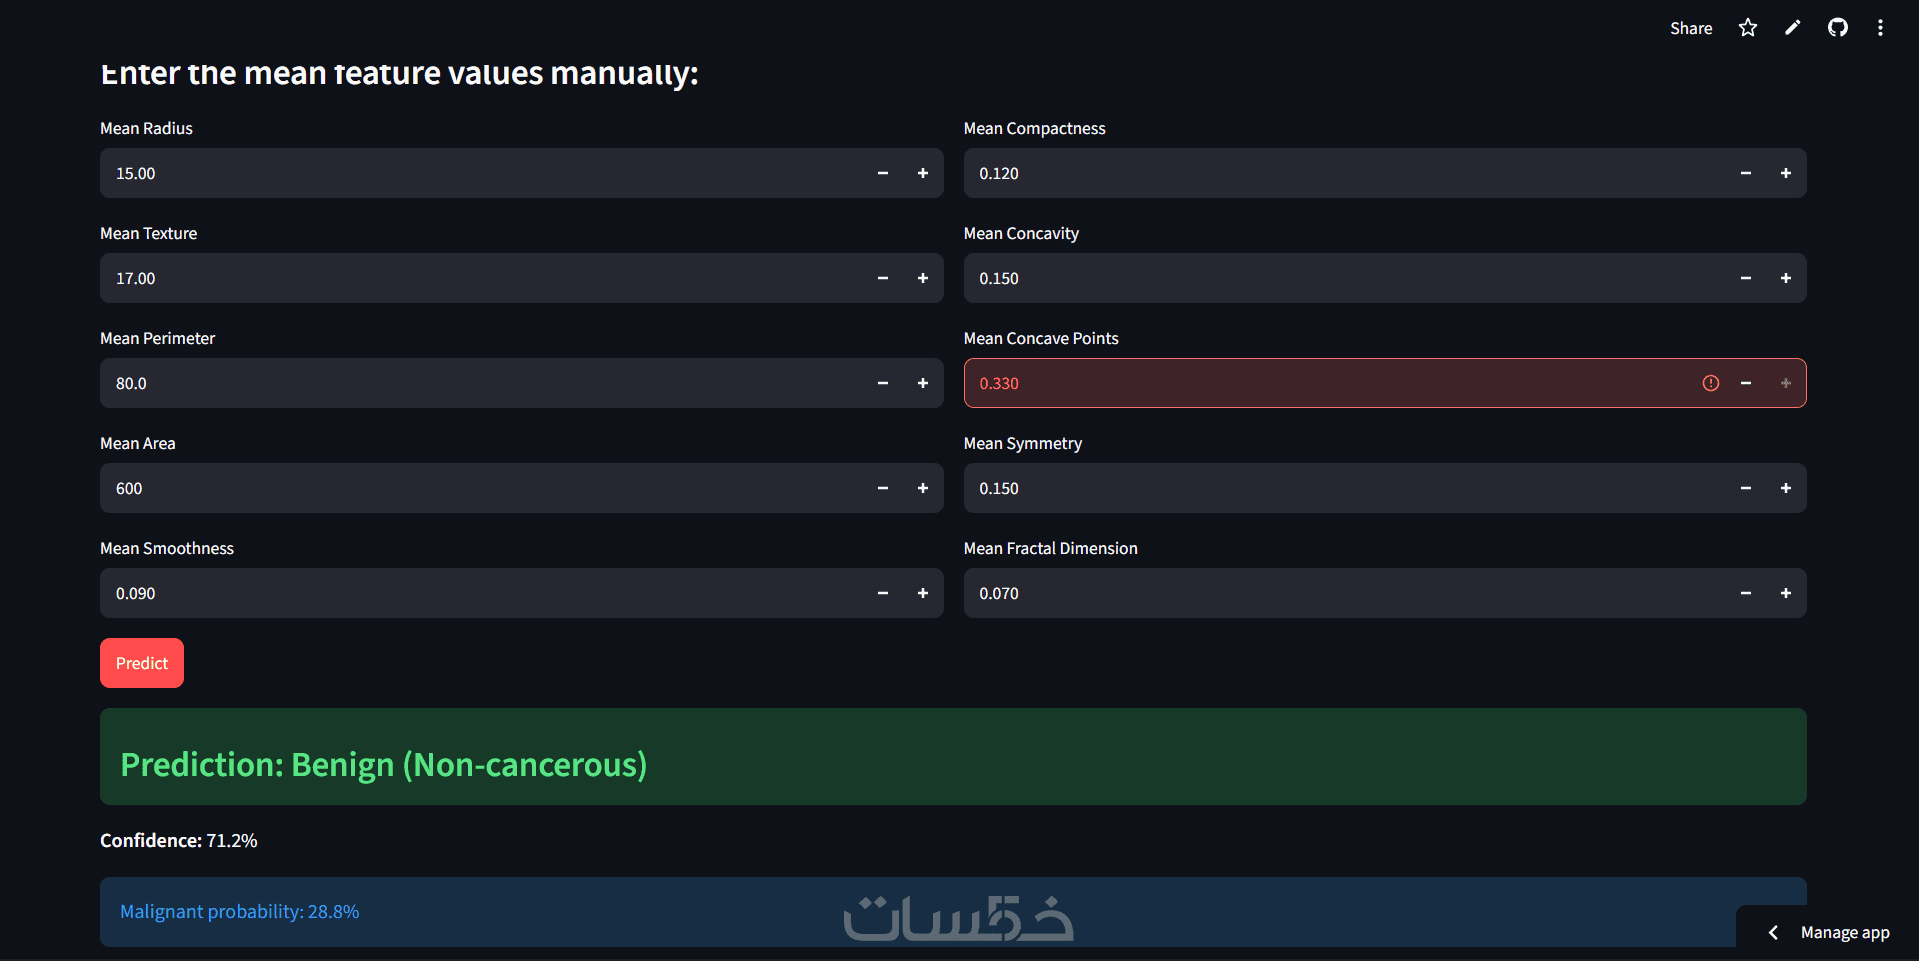
واجهة تفاعلية (Streamlit App): لوحة تحكم تتيح لك إدخال البيانات واختبار نتائج النموذج فوراً.
أو RESTful API (FastAPI / Flask): سكريبت وAPI جاهز لربط النموذج بأي تطبيق موبايل أو موقع إلكتروني.
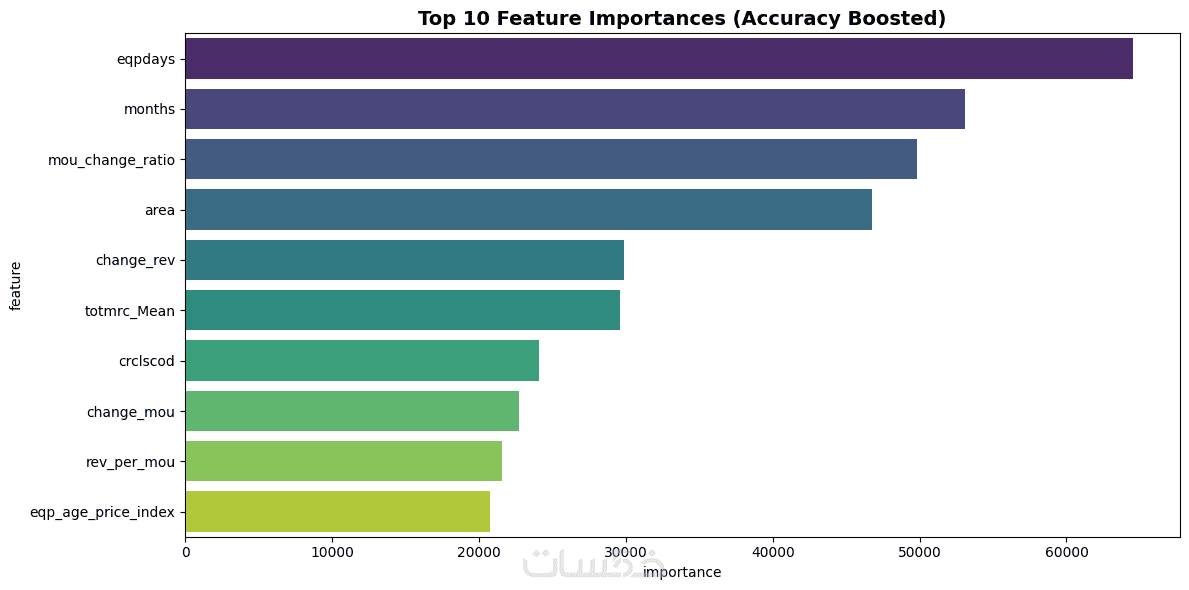
تفسير نتائج النظام (Explainable AI - SHAP):
دمج أداة توضح سبب اتخاذ النظام للقرارات والتوقعات بشكل واصل ومفهوم.
مميزات الخدمة
ليه تشتغل معايا؟
نظام جاهز للاستخدام مباشرة (Production-Ready): بتستلم منتج كامل شغّال مش مجرد ملفات تجريبية.
كود نظيف ومنظم: بناء هيكلية كود ممتازة (Modular Code) مع تعليقات تفصيلية لتسهيل الصيانة والتطوير مستقبلاً.
أعلى معايير السرية: الحفاظ التام على خصوصية بياناتك ومعلومات مشروعك ومسحها بعد التسليم.
دعم ومتابعة: توضيح كيفية تشغيل النظام والتأكد من عمله عندك بدون أي مشاكل.
ما الذي ستستلمه
اللي هسلمهولك عند انتهاء الخدمة:
الكود البرمجي للمشروع بالكامل (Full Project Repository): كود منظم ومقسم لوحدات (Data Prep, Training, Inference, API/App).
النموذج المدرب (Trained Model Artifacts): ملفات .pkl أو .pt جاهزة للتشغيل.
تطبيق الويب أو الـ API الشغّال: ملفات التشغيل المباشر مع دليل سريع للتشغيل (README Guide).
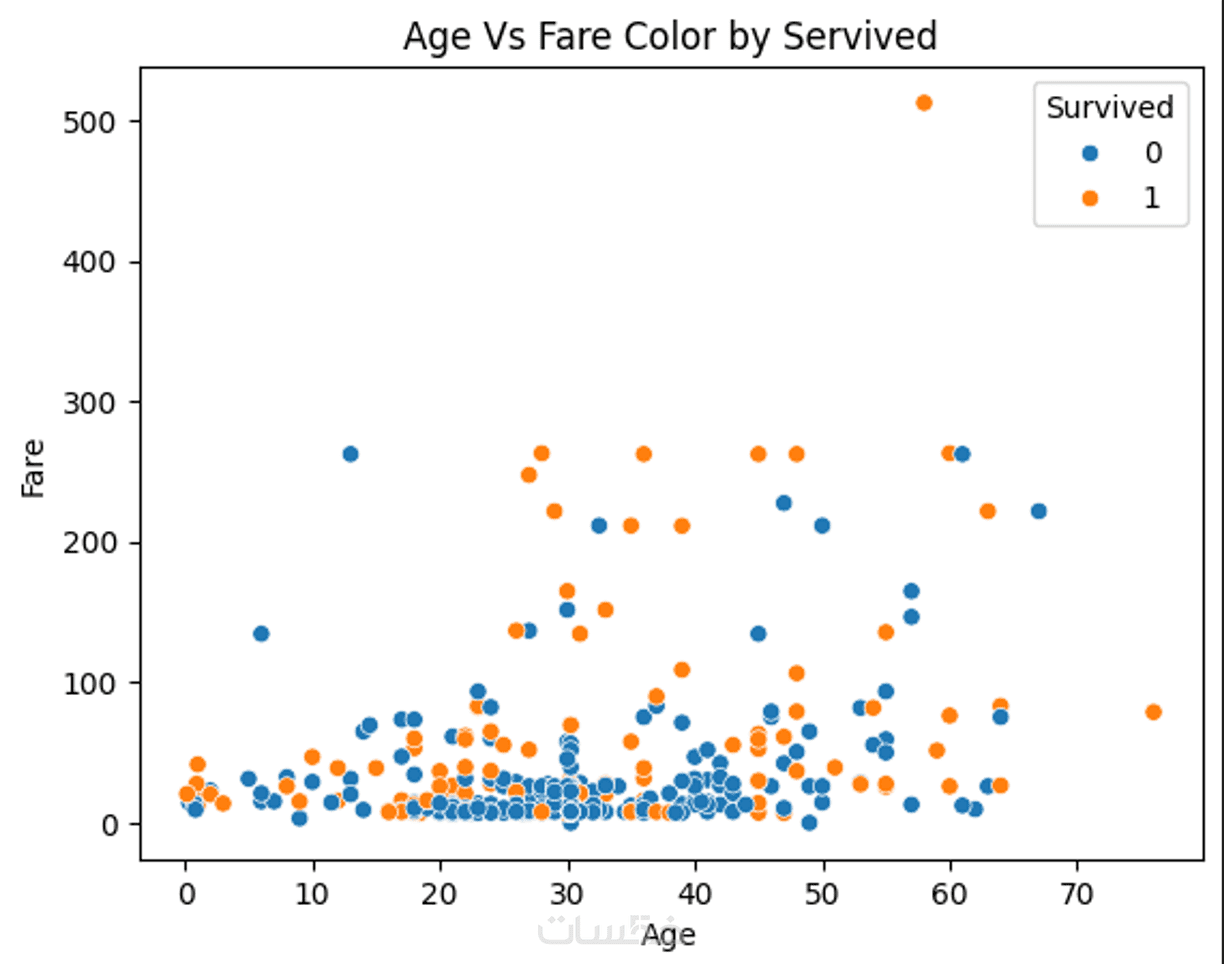
تقرير الأداء والتفسير (Model Evaluation & SHAP Report): تقرير يوضح أداء النظام وكيفية اتخاذه للقرارات.
كلمات مفتاحية
خدمات قد تنال إعجابك


طلب الخدمة
سعر الخدمة
$20.00
خدمات قد تنال إعجابك
كلمات مفتاحية