تحليل البيانات والتنبؤ بها
تحليل البيانات والتنبؤ بها
وصف الخدمة
هل لديك بيانات وتريد استخراج قيمة حقيقية منها باستخدام الذكاء الاصطناعي؟
سأقوم بتصميم وتطوير نماذج تعلم آلي (Machine Learning) مع التركيز على الدقة والكفاءة.
ما الذي أقدمه في هذه الخدمة:
- معالجة البيانات وتنظيفها (Data Preprocessing)
- تحليل البيانات واستخراج المميزات (Feature Engineering).
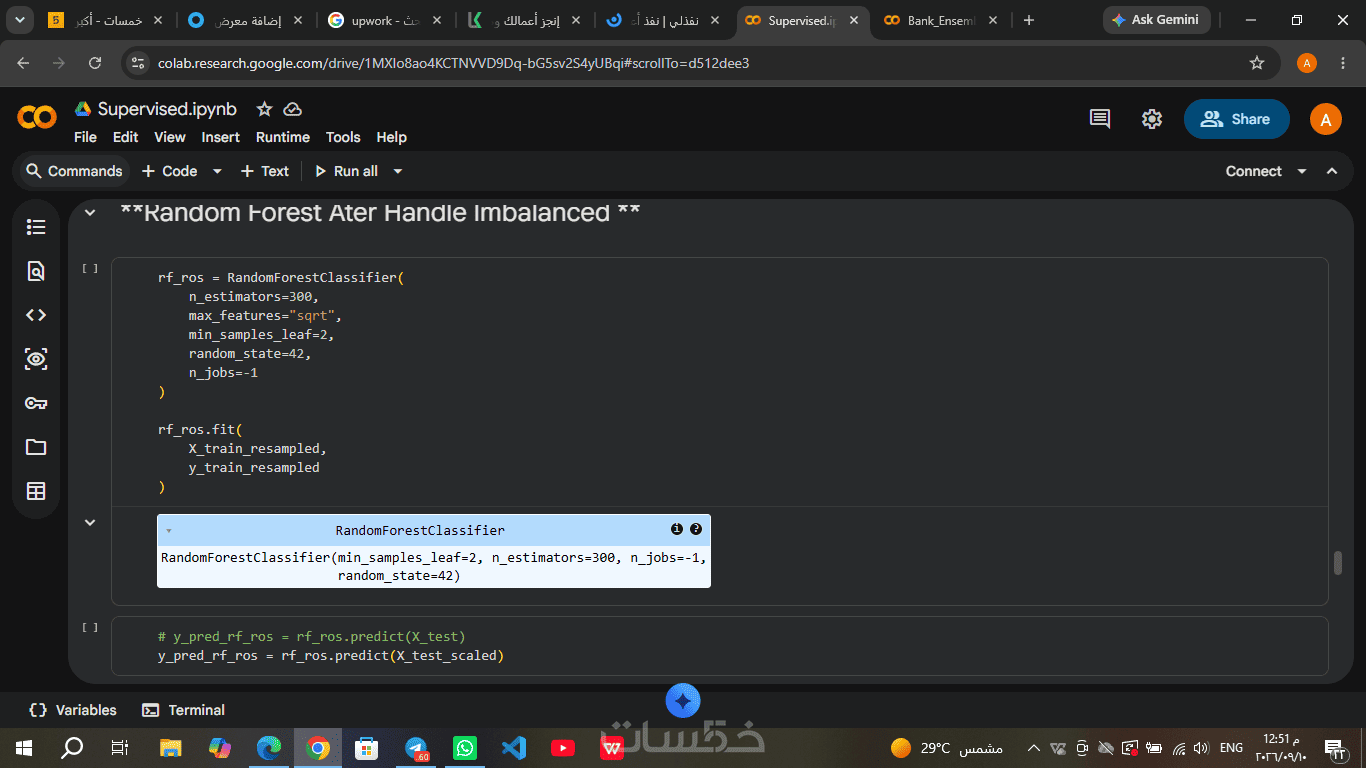
- بناء1- 3 نماذج تعلم آلي باستخدام خوارزميات متقدمة مثل: الانحدار، الأشجار، SVM، XGBoost، CatBoost وغيرها.
- تدريب النماذج وتحسين أدائها (Hyperparameter Tuning).
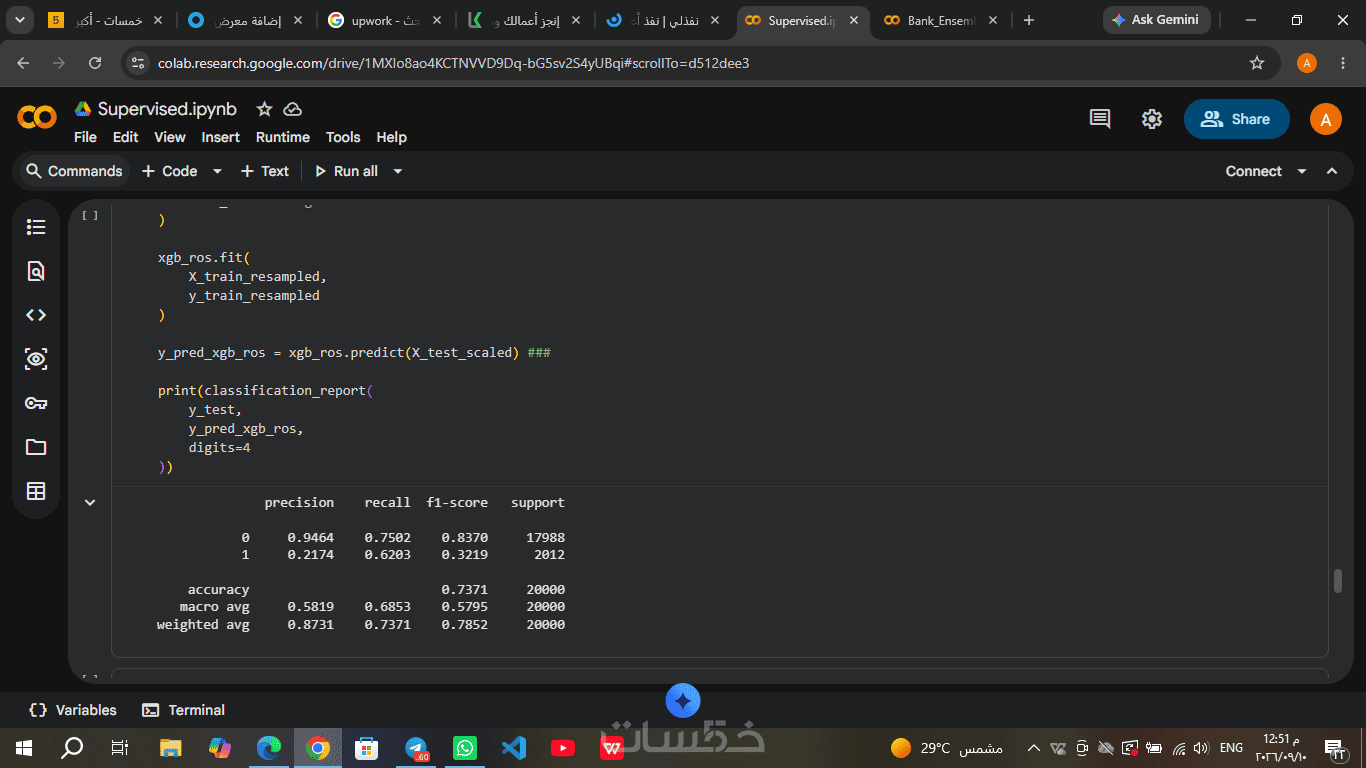
- تقييم النموذج وشرح النتائج برسوم بيانية وتقارير(f1-core, accuracy, recall, precision, & confusion matrix).
- تسليم الكود موثقًا وقابلًا لإعادة الاستخدام.
مميزات الخدمة
مميزات الخدمه
تنظيف وإعداد البيانات (Data Cleaning)
التعامل مع القيم المفقودة، حذف البيانات المكررة، وتحويل الصيغ لتجهيز الداتا سيت بشكل صحيح قبل مرحلة التدريب.
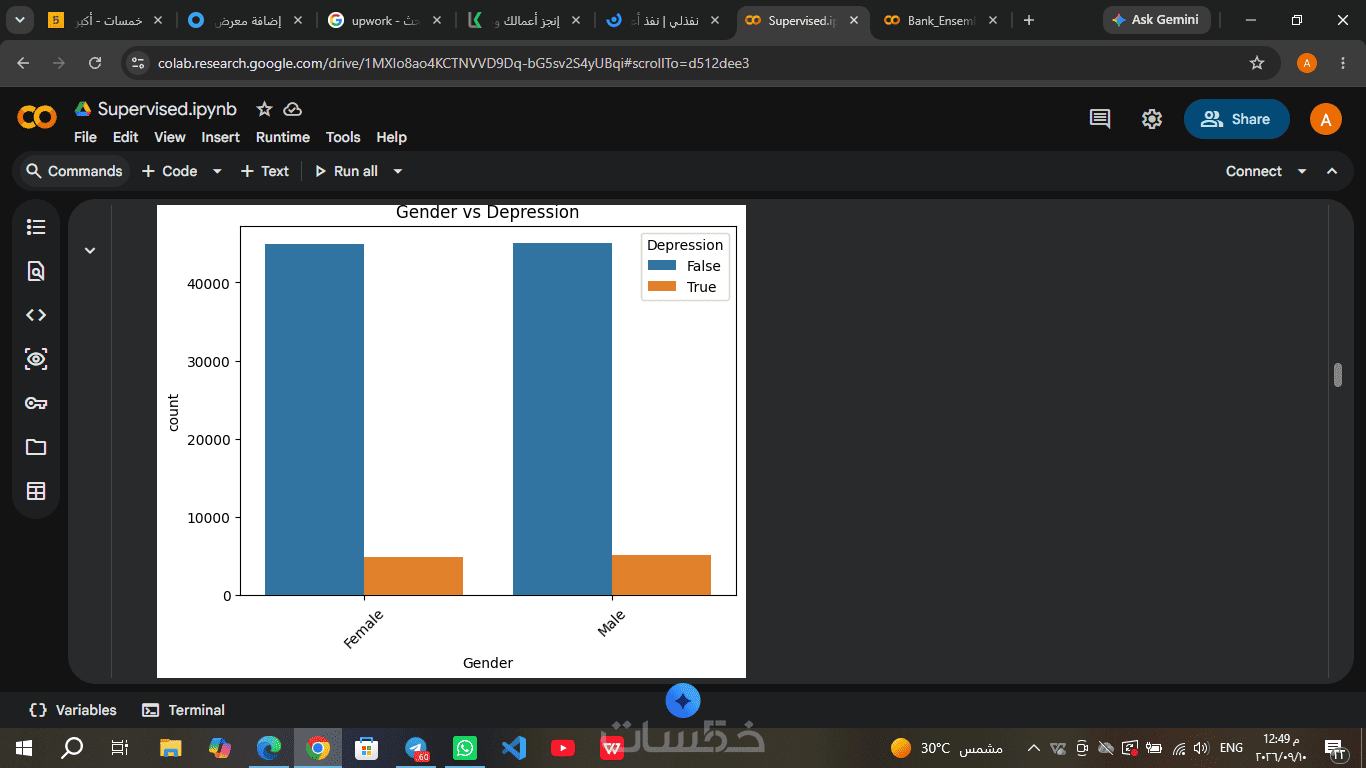
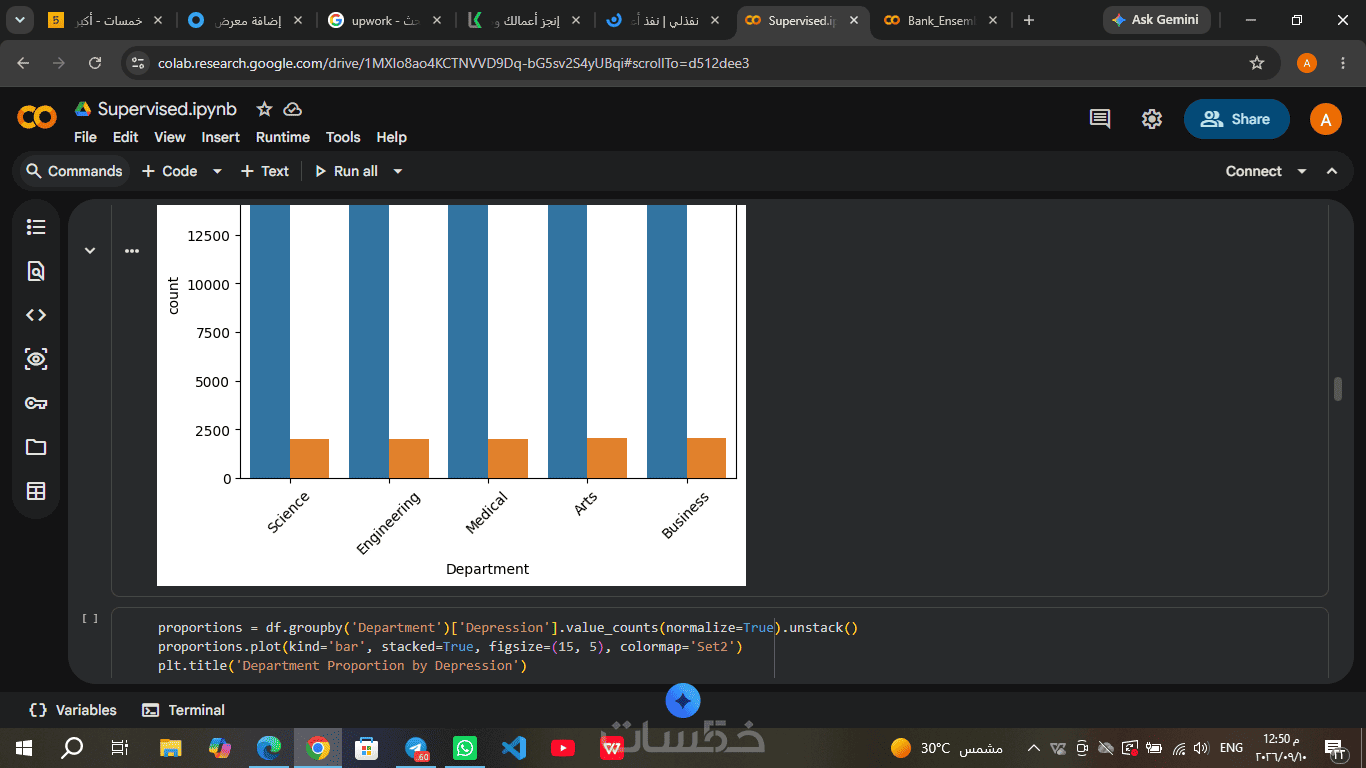
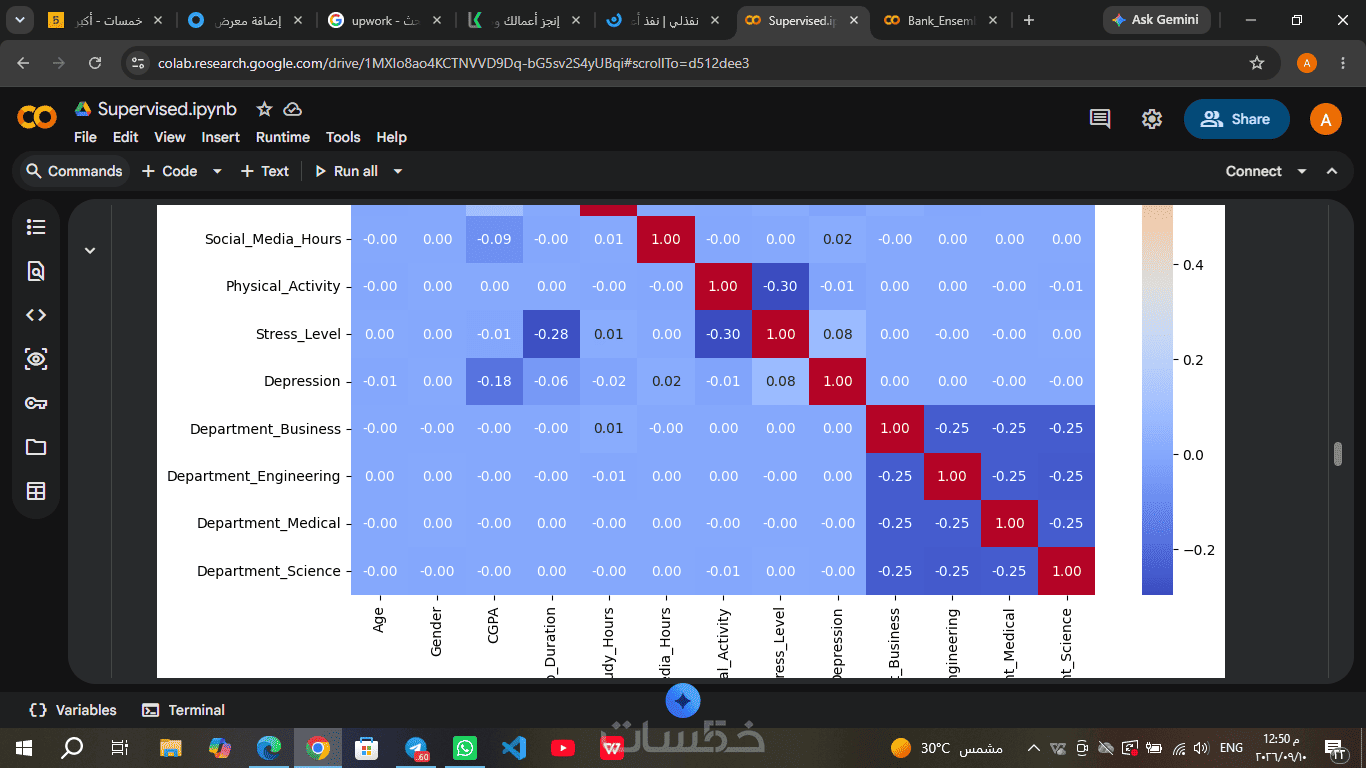
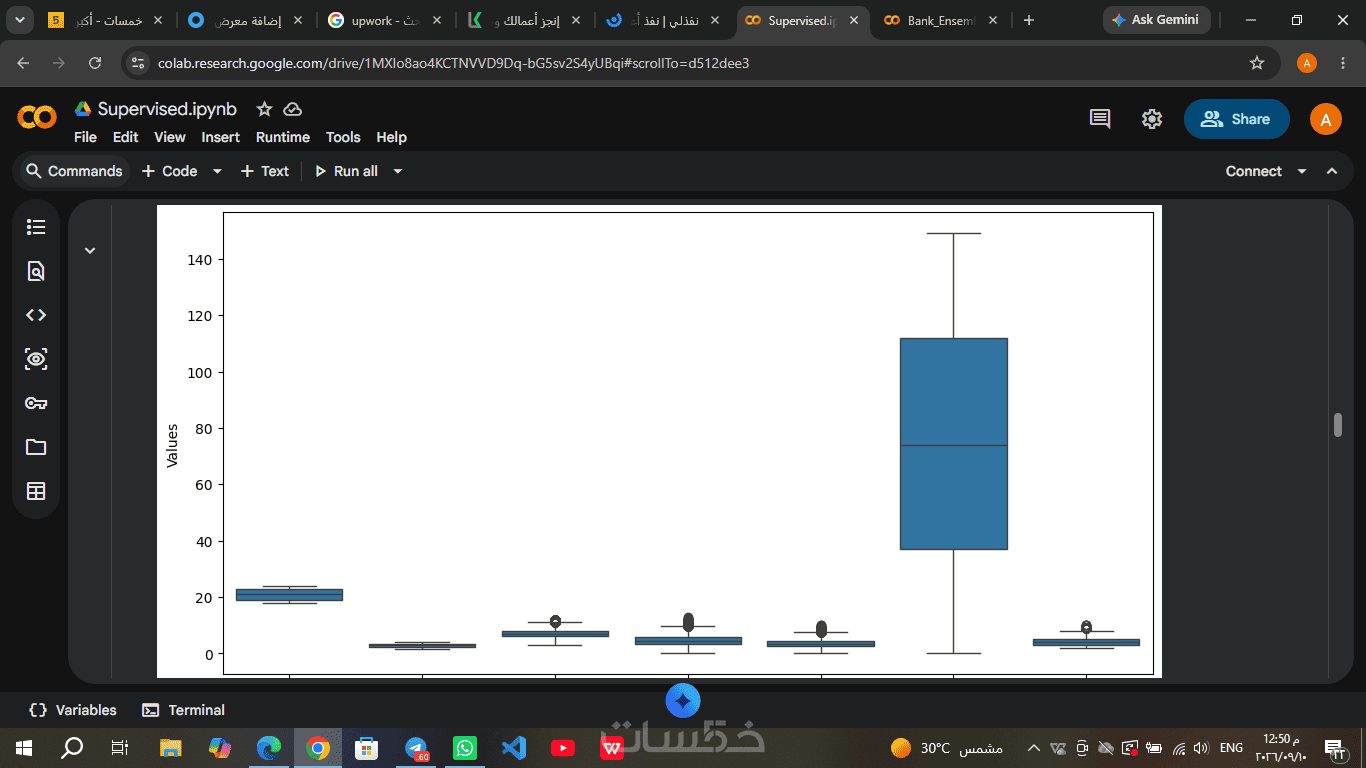
استخراج الإحصائيات وبناء رسومات بيانية توضيحية (Charts & Graphs) تظهر الأنماط المخفية داخل البيانات.
استخدام تقنيات برمجية حديثة
الاعتماد على أقوى مكتبات لغة بايثون مثل Pandas, NumPy, Scikit-learn, Seaborn لضمان سرعة ودقة المعالجة.
نطاق الخدمة الأساسية:
العمل على بيانات تصل إلى 10,000 سجل كحد أقصى (Rows) للبيانات الجدولية
أو حتى 1,000 صورة في حالة مشاريع الرؤية الحاسوبية
أو حتى 5,000 جملة/نص في مشاريع معالجة اللغة الطبيعية
تشمل الخدمة:
-تنظيف البيانات (Data Preprocessing)
- تدريب النموذج
- تقييم الأداء باستخدام Metrics مناسبة
أي حجم بيانات أكبر من ذلك أو متطلبات إضافية يتم الاتفاق عليها كخدمة تطوير (Extras)
ما الذي ستستلمه
ما الذى ستستلمه
كود برمجي منظم وموثق
ستحصل على ملفات كود نظيفة وقابلة للتعديل، مع تعليقات توضيحية تسهّل عليك فهم طريقة عمل النموذج وإعادة استخدامه لاحقًا.
النموذج المدرب (Trained Model)
ملف النموذج الجاهز للاستخدام مباشرة في مشروعك أو نظامك، مع إمكانية إعادة التدريب على بيانات جديدة إذا رغبت.
تقرير شامل بالنتائج
يشمل شرحًا للأداء (Accuracy, Precision, Recall, F1-Score) مع رسوم بيانية ومنحنيات ROC/PR لعرض دقة النموذج بشكل بصري سهل الفهم.
معالجة البيانات وتنظيفها
نسخة من البيانات بعد معالجتها وتجهيزها للنماذج (إن كان ذلك ضمن نطاق الخدمة) لتتمكن من استخدامها مستقبلاً.
دعم بعد التسليم
فترة دعم قصيرة للإجابة عن استفساراتك وتوضيح أي نقطة غير واضحة في النتائج أو الكود.
كلمات مفتاحية
خدمات قد تنال إعجابك


طلب الخدمة
سعر الخدمة
$10.00
خدمات قد تنال إعجابك
كلمات مفتاحية