سأبني لك نموذج Machine Learning يتنبأ بما يحتاجه مشروعك.
سأبني لك نموذج Machine Learning يتنبأ بما يحتاجه مشروعك.
ما تشمله الباقة الأساسية
- ملف بيانات واحد (Excel أو CSV) حتى 5,000 صف و15 عمود
- هدف واحد للتنبؤ (عمود واحد تحدده أنت)
- مقارنة بين 3 خوارزميات (Ridge وRandom Forest وGradient Boosting)
- تجهيز بسيط للبيانات (ترميز وتطبيع)، والبيانات تكون شبه نظيفة
- النموذج المدرب + الكود + تقرير قصير بمقدار الخطأ
- تعديل واحد بعد التسليم
ما لا تشمله الباقة الأساسية (متوفر كتطويرات أو بسعر منفصل):
- تحويل النموذج لـ API أو Docker أو نشره على AWS
- تنظيف بيانات فوضوية أو ناقصة بشكل كبير
- ملفات أكبر من الحد أعلاه
- أكثر من هدف للتنبؤ
- البيانات غير الجدولية (صور، نصوص، سلاسل زمنية معقدة)
مميزات الخدمة
مقارنة بين عدة خوارزميات
أجرب Ridge وRandom Forest وGradient Boosting وأختار الأدق لبياناتك.
تجهيز البيانات
تنظيف وترميز وتطبيع، لأن جودة النموذج تعتمد على هذه الخطوة.
أرقام واضحة للدقة
تقرير يوضح مقدار الخطأ (MAE)، وما أقول لك "دقة عالية" بدون أرقام.
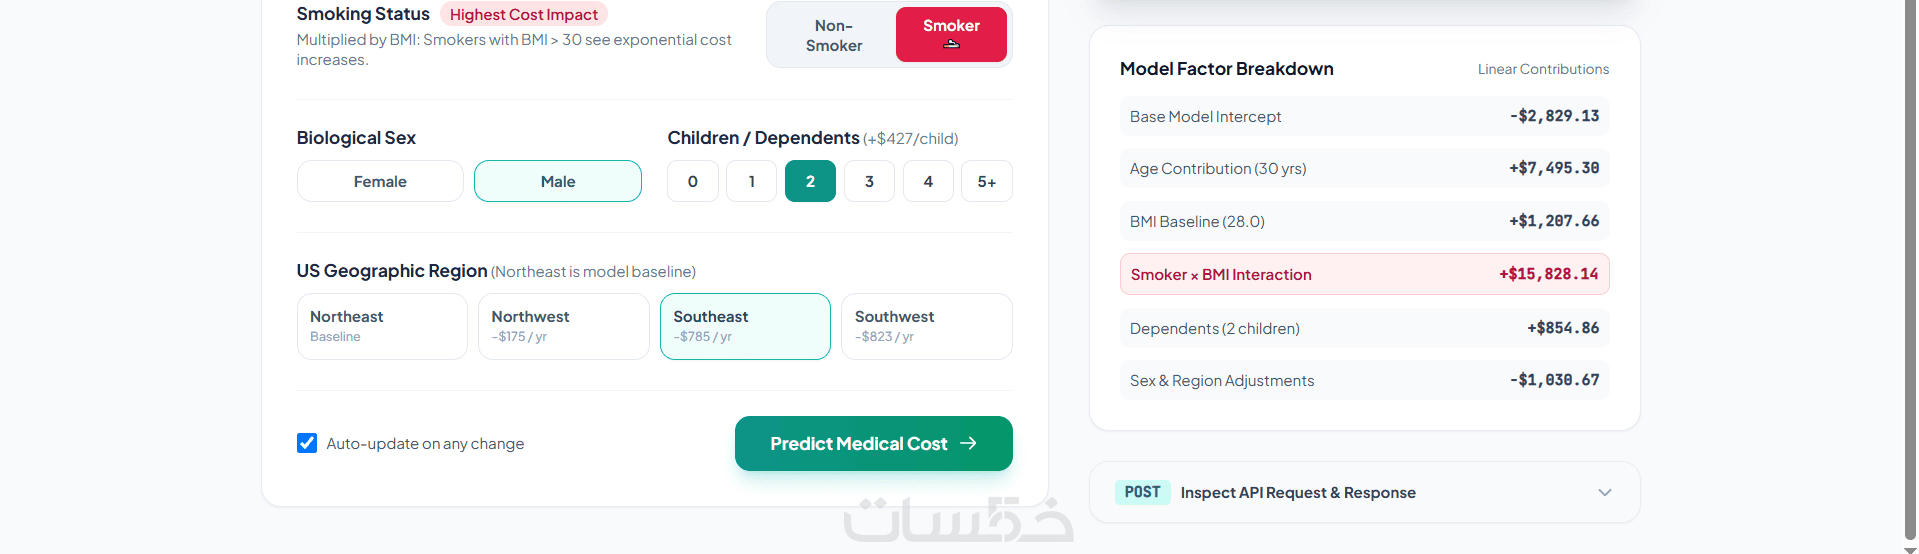
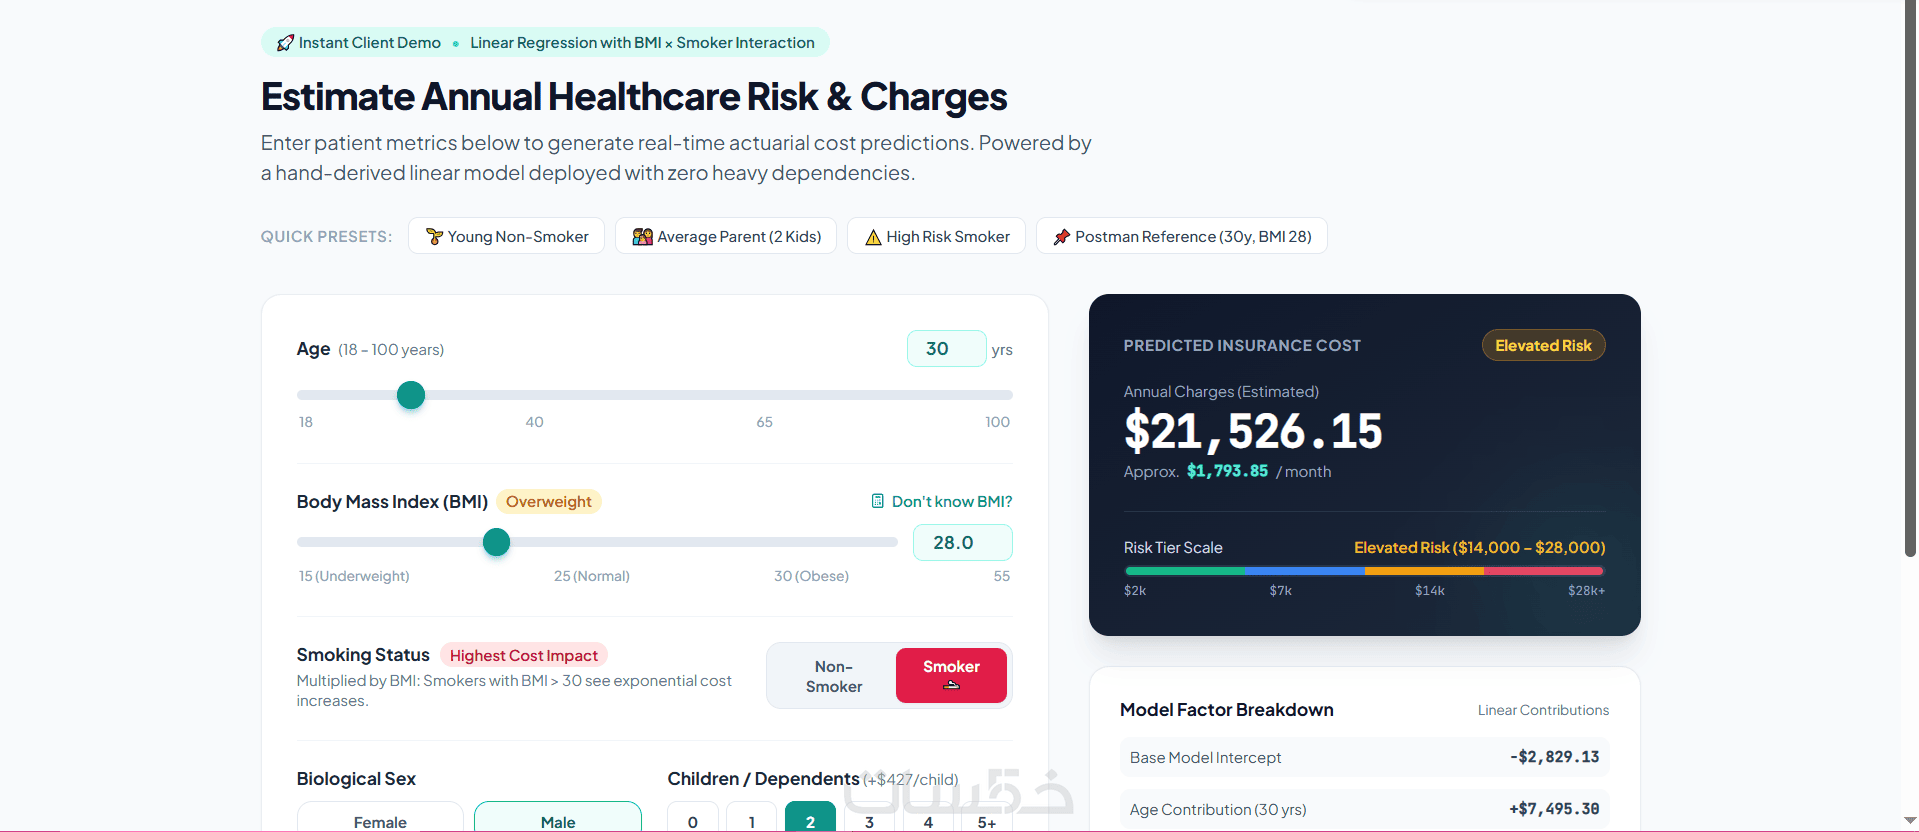
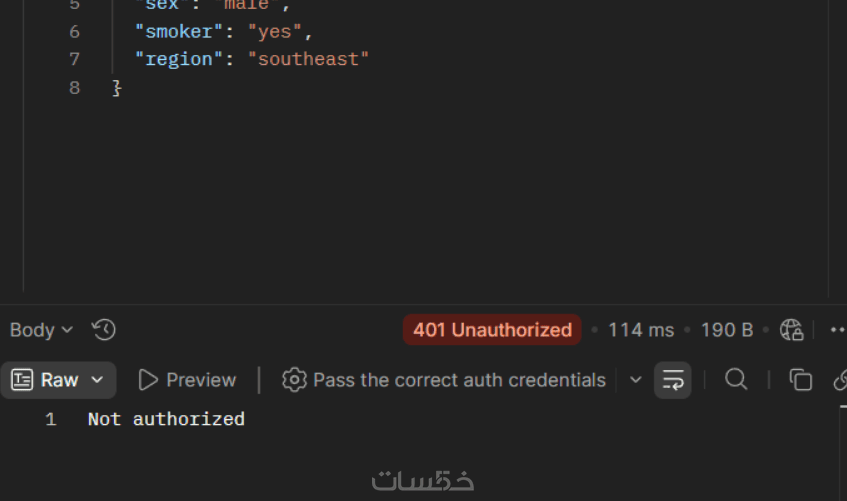
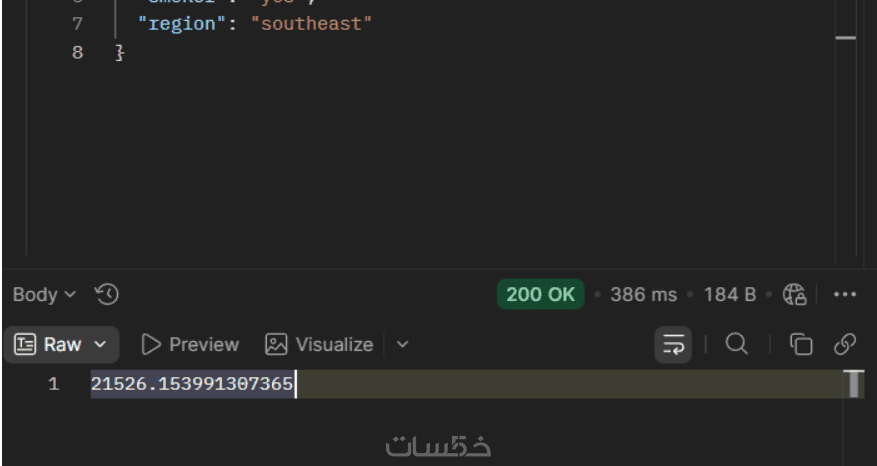
يشتغل كـ API
تستدعيه من موقعك أو تطبيقك وترجع لك النتيجة (حسب الباقة).
ما الذي ستستلمه
النموذج المدرب
ملف جاهز للاستخدام، تقدر تشغله على بيانات جديدة.
الكود كامل
Notebook أو سكربت Python مرتب، ملكك بالكامل.
تقرير النتائج
مقارنة الخوارزميات وأي واحدة اخترتها ولماذا.
شرح الاستخدام
خطوات بسيطة لتشغيل النموذج بنفسك.
كلمات مفتاحية
خدمات قد تنال إعجابك


طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
تحويله ل API
10.00
|
|
Docker
5.00
|
|
واجهه بسيطة
5.00
|


طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
تحويله ل API
10.00
|
|
Docker
5.00
|
|
واجهه بسيطة
5.00
|
خدمات قد تنال إعجابك
كلمات مفتاحية
