بناء وتدريب نماذج تعلم الآلة واستخراج التوقعات
بناء وتدريب نماذج تعلم الآلة واستخراج التوقعات
وصف الخدمة
عالجة البيانات وتجهيزها (Data Preprocessing): تنظيف البيانات، التعامل مع القيم المفقودة، وتحويل الخصائص (Feature Encoding & Scaling).
بناء وتقييم النماذج (Model Building & Evaluation):
نماذج التصنيف والانحدار (Classification & Regression) مثل: Linear/Logistic Regression, Decision Trees, Random Forest, SVM.
نماذج التجميع (Clustering) مثل: K-Means.
قياس دقة النموذج (Performance Metrics): قياس الأداء باستخدام (Accuracy, Precision, Recall, F1-Score, MSE).
ضبط المعلمات الفائقة (Hyperparameter Tuning): تحسين أداء النموذج للوصول لأعلى دقة ممكنة.
حجم ومواصفات العمل مقابل الخدمة الأساسية :
تنظيف وتجهيز البيانات لبناء وتدريب نموذج تعلم آلة واحد (Classification أو Regression أو Clustering).
تطبيق ذلك على ملف بيانات يحتوي على حتى 500 سطر (Rows) وبحد أقصى 10 أعمدة (Columns).
(ملاحظة: إذا كان حجم البيانات أكبر من 500 سطر، يُرجى تحديد الزيادة من تطويرات الخدمة أدناه).
مميزات الخدمة
تسليم كود برميجي منظم ومكتوب وفق أحدث المعايير
كود موثق بأسلوب احترافي مع تعليقات توضيحية لسهولة الفهم والتطوير.
التزام تام بموعد التسليم وشرح النتائج بوضوح.
تسليم المخرجات في الوقت المحدد مع توضيح شامل لكيفية عمل النموذج.
ما الذي ستستلمه
ملف الكود البرمجي (Jupyter Notebook)
ملف كود Python كامل يتضمن خطوات المعالجة، التدريب، والتقييم.
ملف النموذج المدرب (Model File)
ملف النموذج جاهز للاستخدام والتطبيق مباشرة بصيغة pkl أو joblib.
تقرير تقييم أداء النموذج
تقرير شامل لمقاييس الدقة والنتائج المباشرة مع الرسوم البيانية.
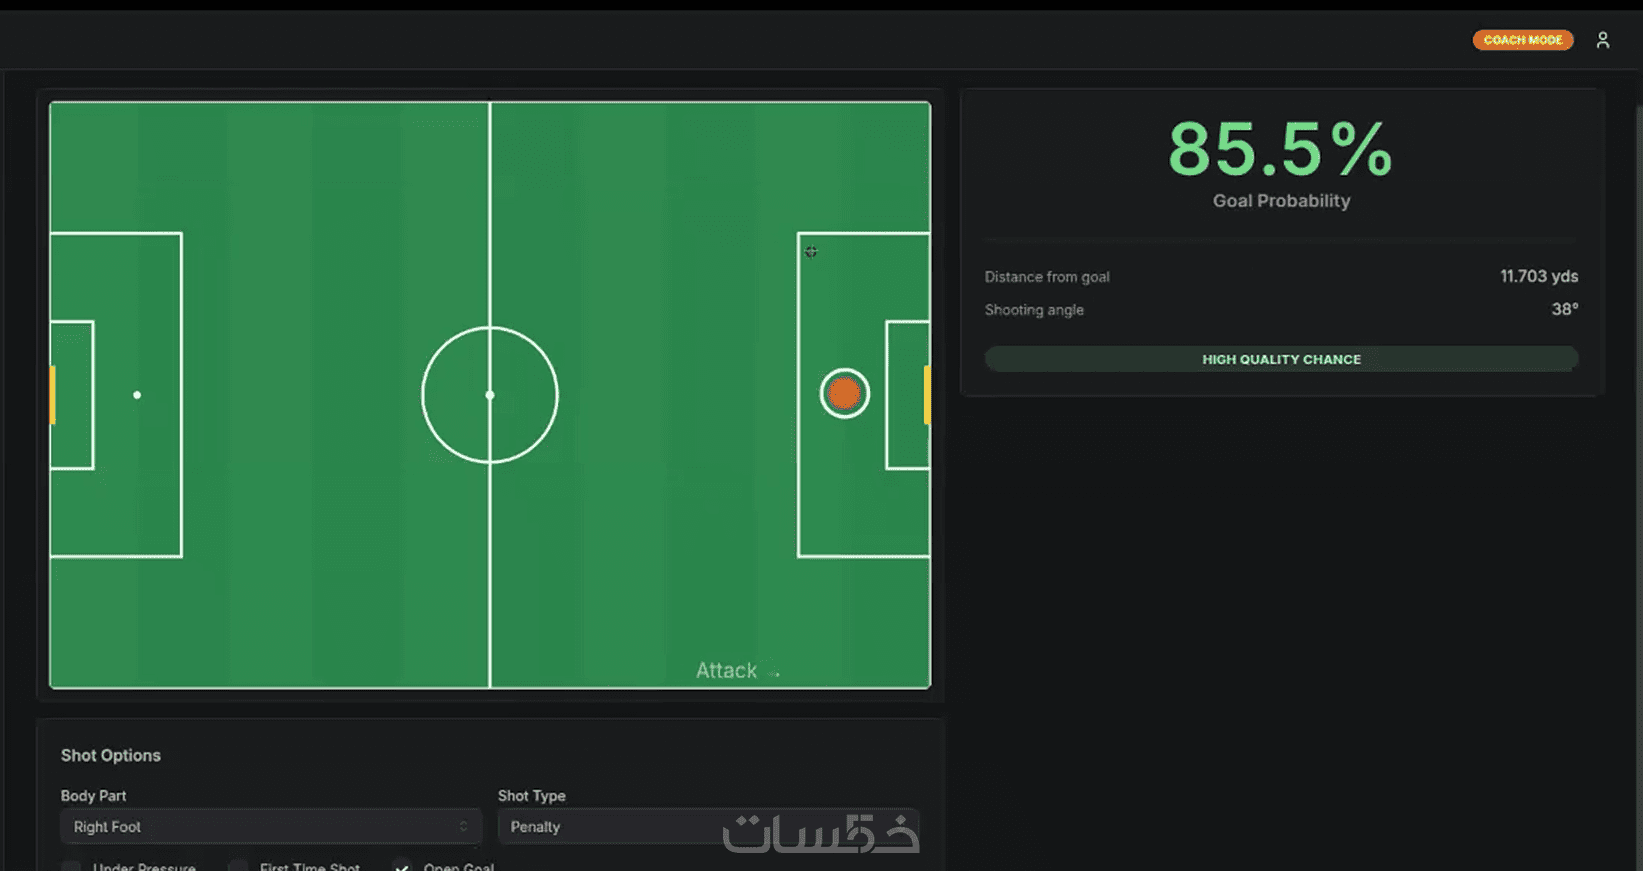
نموذج الأهداف المتوقعة وتتبع التسديدات
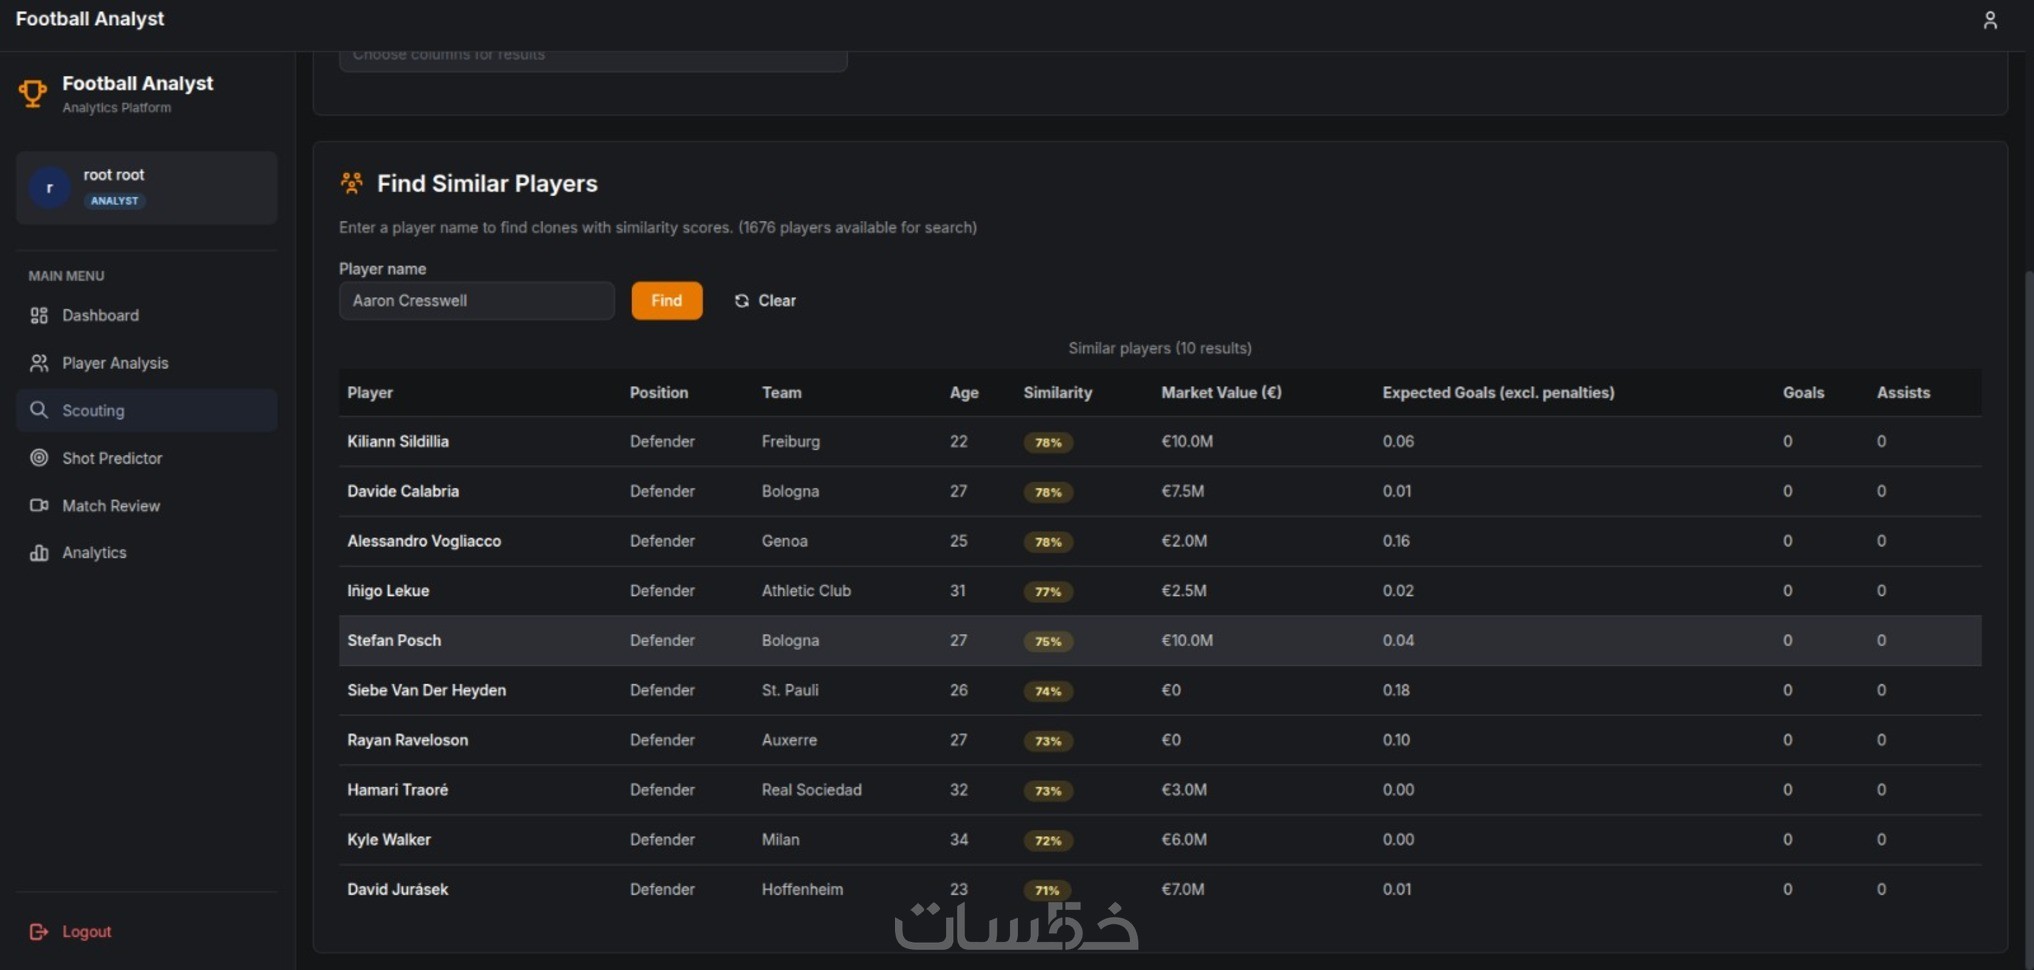
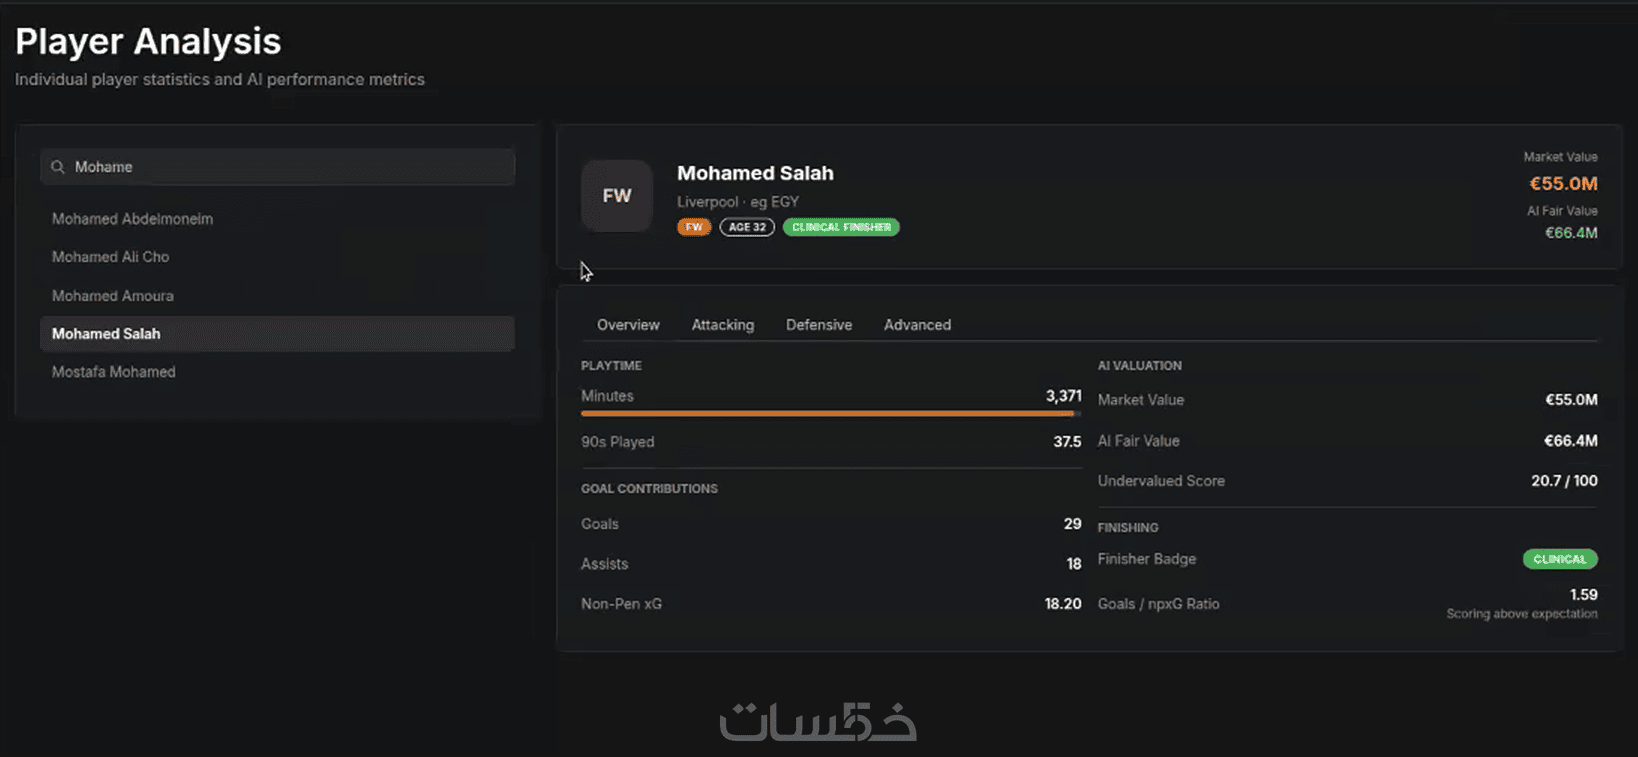
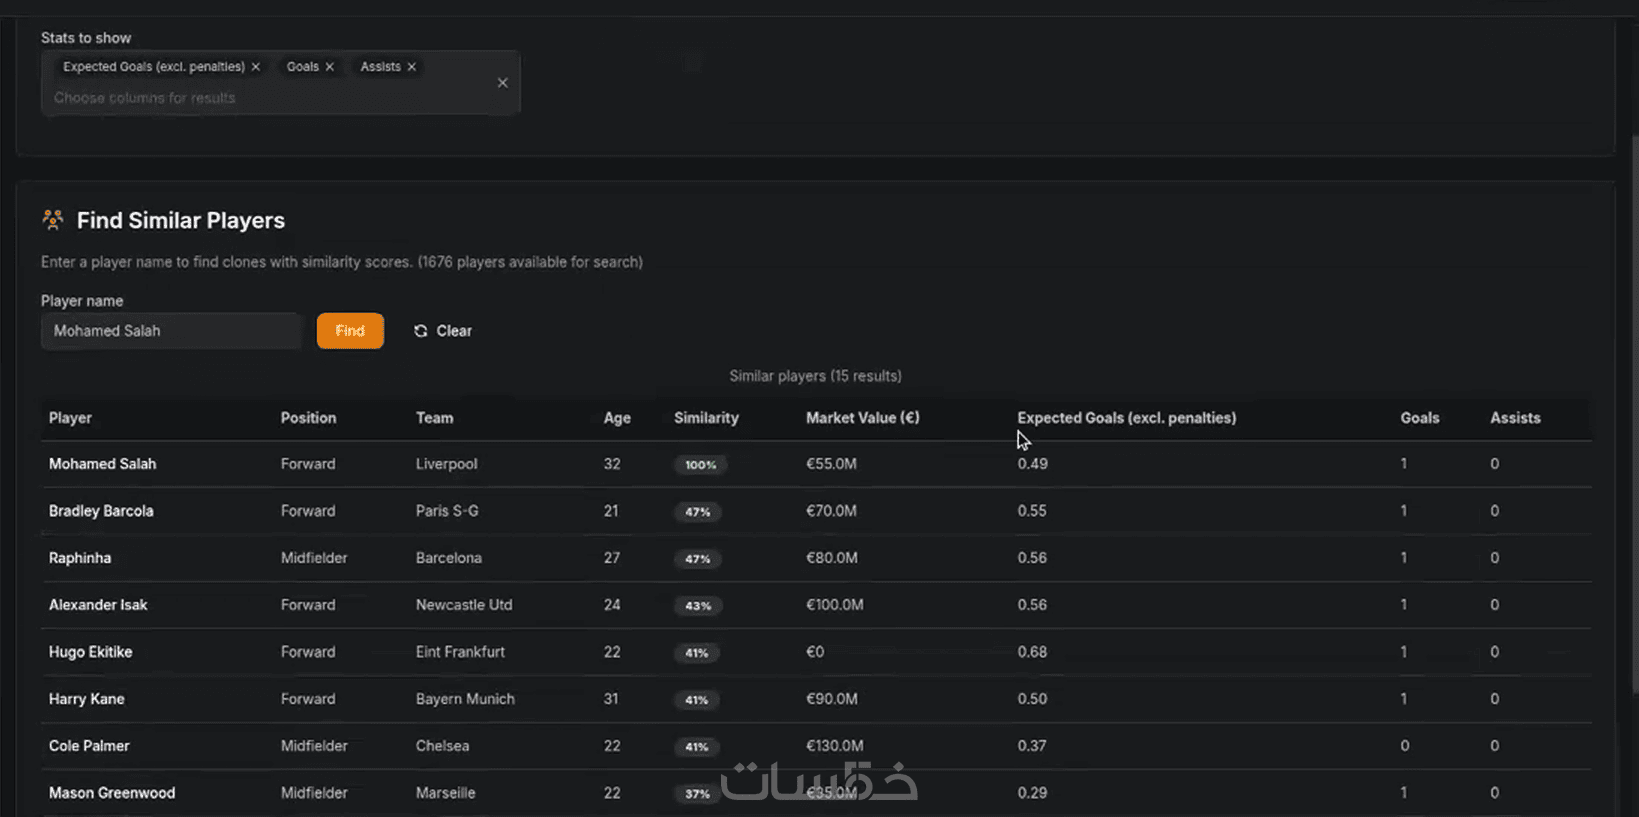
نظام اكتشاف واستكشاف اللاعبين
كلمات مفتاحية
خدمات قد تنال إعجابك


طلب الخدمة
سعر الخدمة
$10.00
تطويرات اختيارية
بيانات حجمها من501 حتي3000 سطر
5.00
|
|
بيانات حجمها من3001 ختي 10000سطر
10.00
|


طلب الخدمة
سعر الخدمة
$10.00
تطويرات اختيارية
بيانات حجمها من501 حتي3000 سطر
5.00
|
|
بيانات حجمها من3001 ختي 10000سطر
10.00
|
خدمات قد تنال إعجابك
كلمات مفتاحية
