بناء نموذج ذكاء اصطناعي NLP لتصنيف الرسائل وتحديد Spam
بناء نموذج ذكاء اصطناعي NLP لتصنيف الرسائل وتحديد Spam
وصف الخدمة
هبني لك نموذج ذكاء اصطناعي بلغة Python يصنّف الرسائل النصية إلى Spam / Not Spam باستخدام تقنيات معالجة اللغة الطبيعية (NLP).
تفاصيل الخدمة الأساسية:
- تدريب النموذج على داتا سيت واحد (لحد 5,000 رسالة)
- لغة الرسائل: عربي أو إنجليزي (لغة واحدة)
- الخوارزمية: Logistic Regression أو Naive Bayes
- تنظيف ومعالجة النصوص (Preprocessing)
- تقييم النموذج بالدقة (Accuracy) و F1-Score
هتستلم:
1. ملف Jupyter Notebook فيه الكود كامل ومشروح
2. النموذج المدرّب (ملف جاهز للاستخدام)
3. تقرير مختصر بنتايج الدقة
أي حاجة زيادة (داتا أكبر، لغتين، BERT، واجهة تجريبية) متاحة في الخدمات الإضافية.
مميزات الخدمة
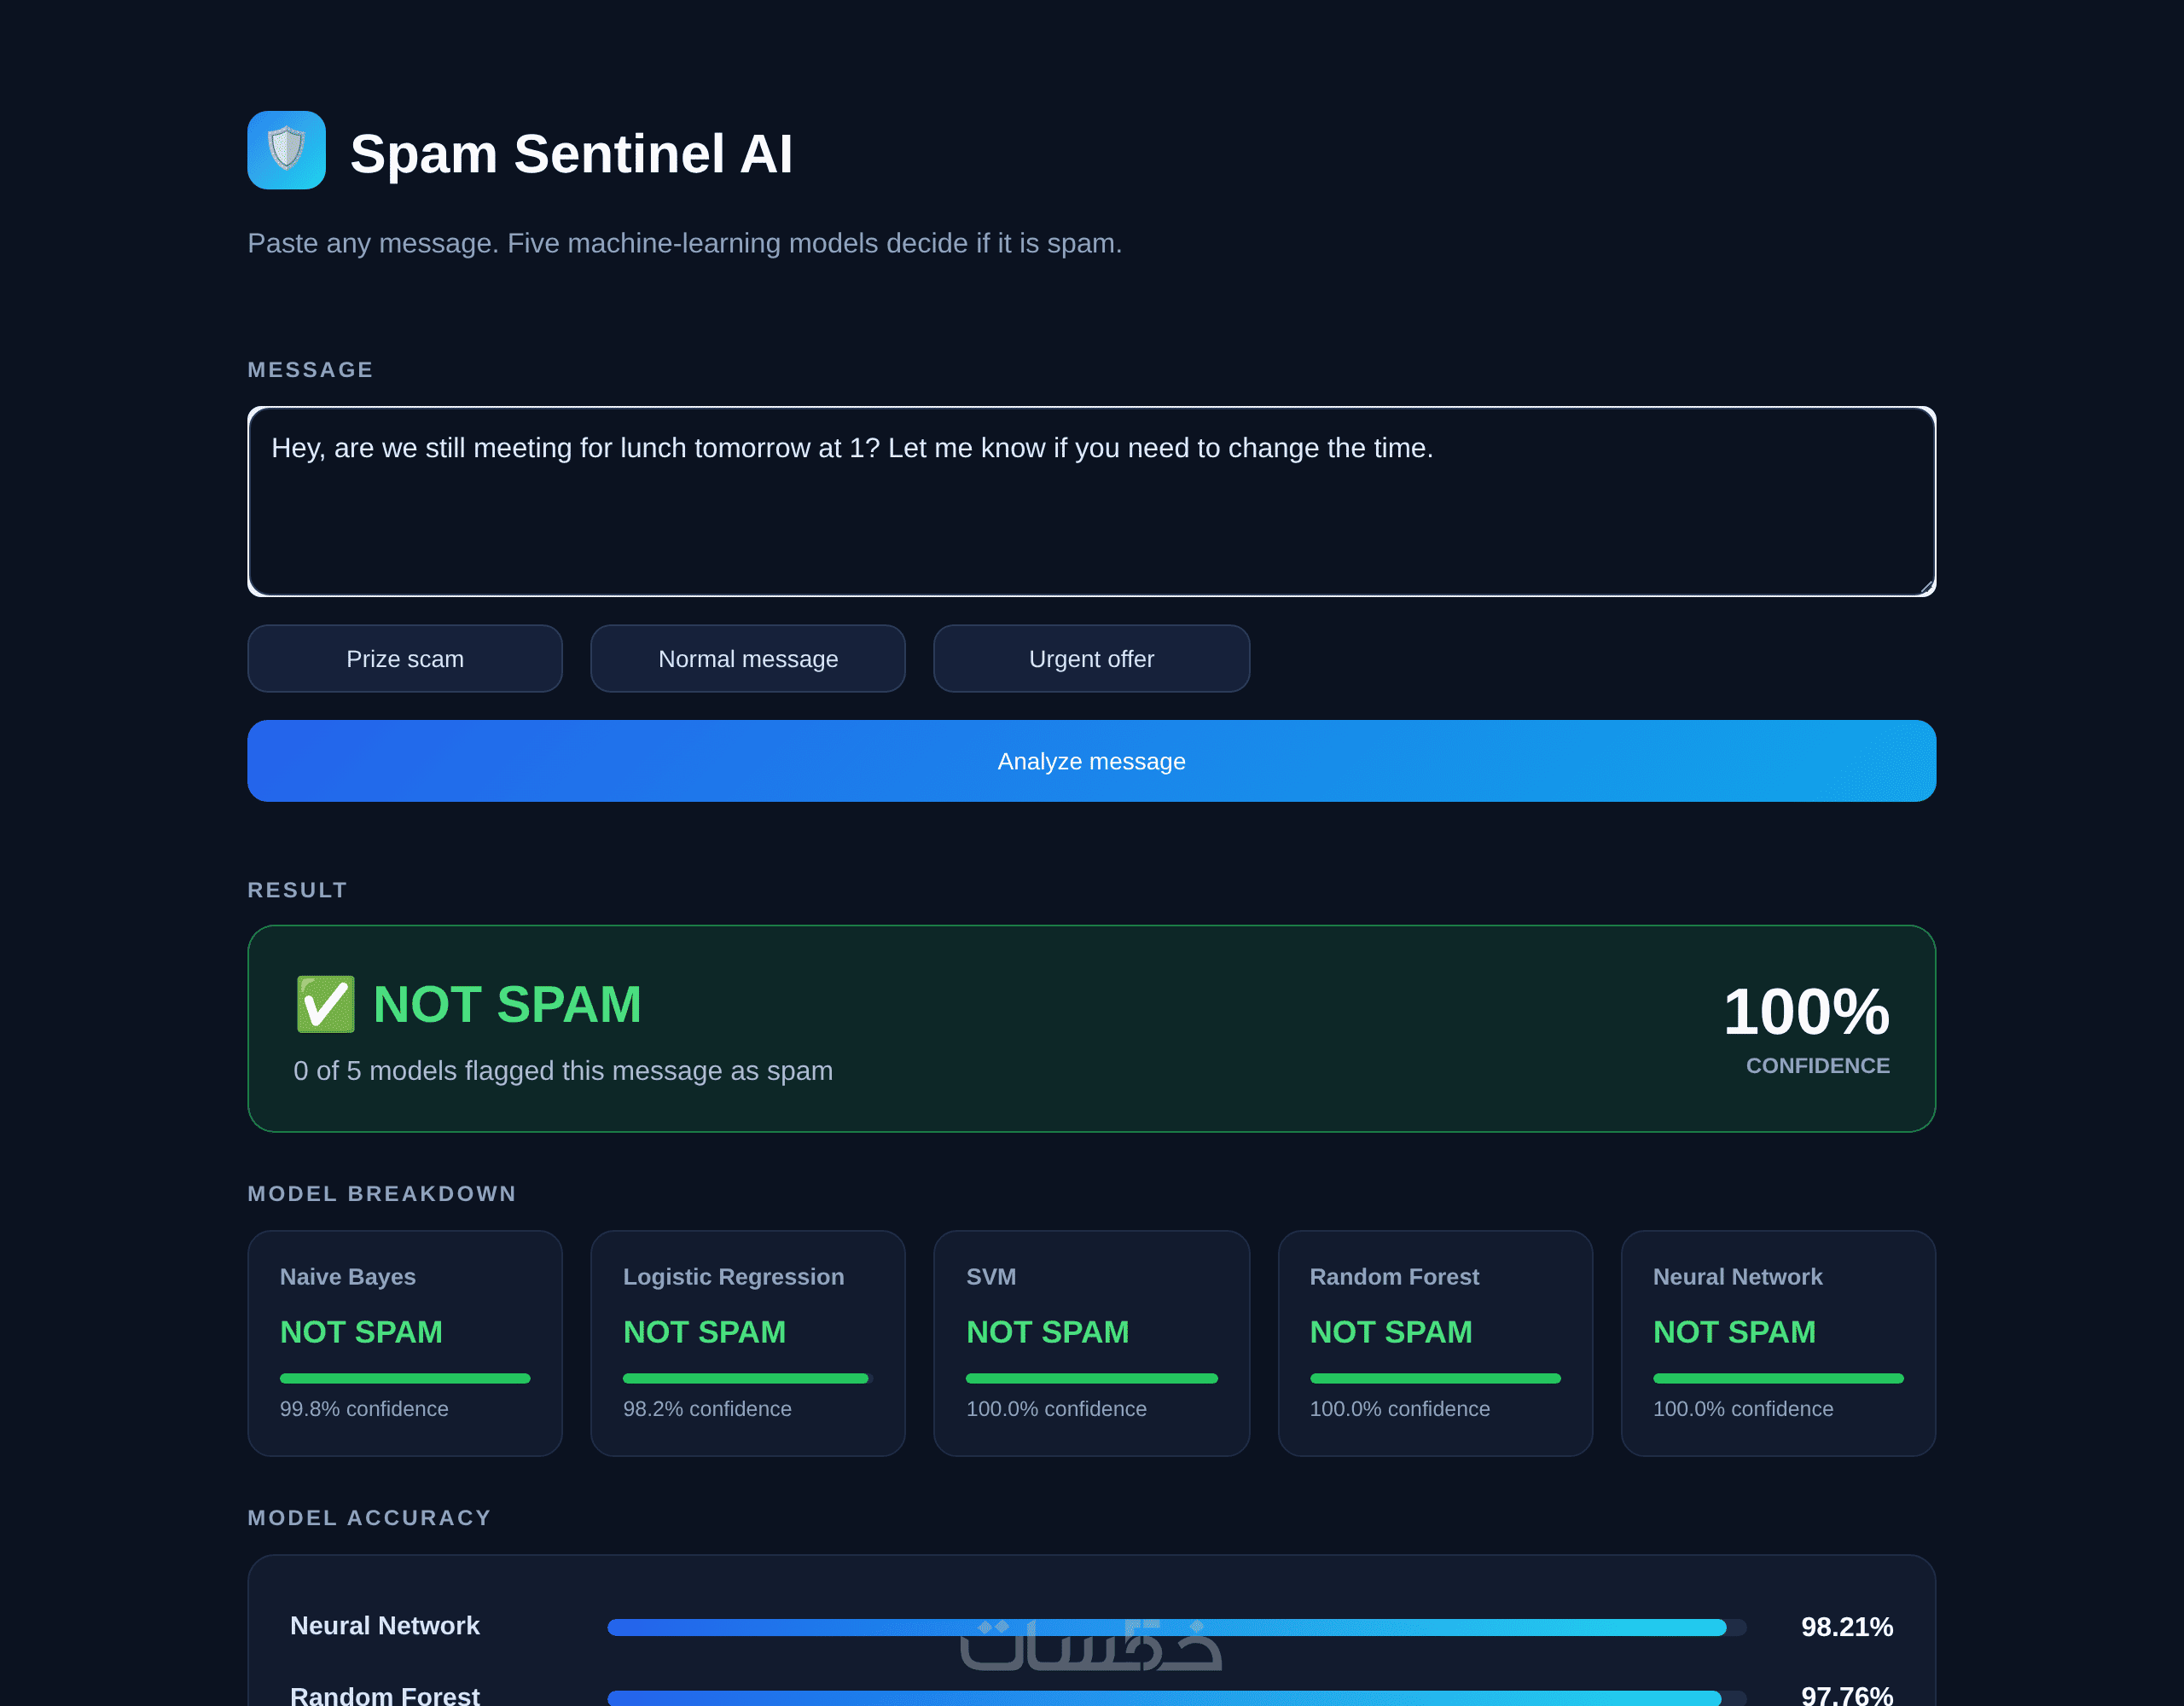
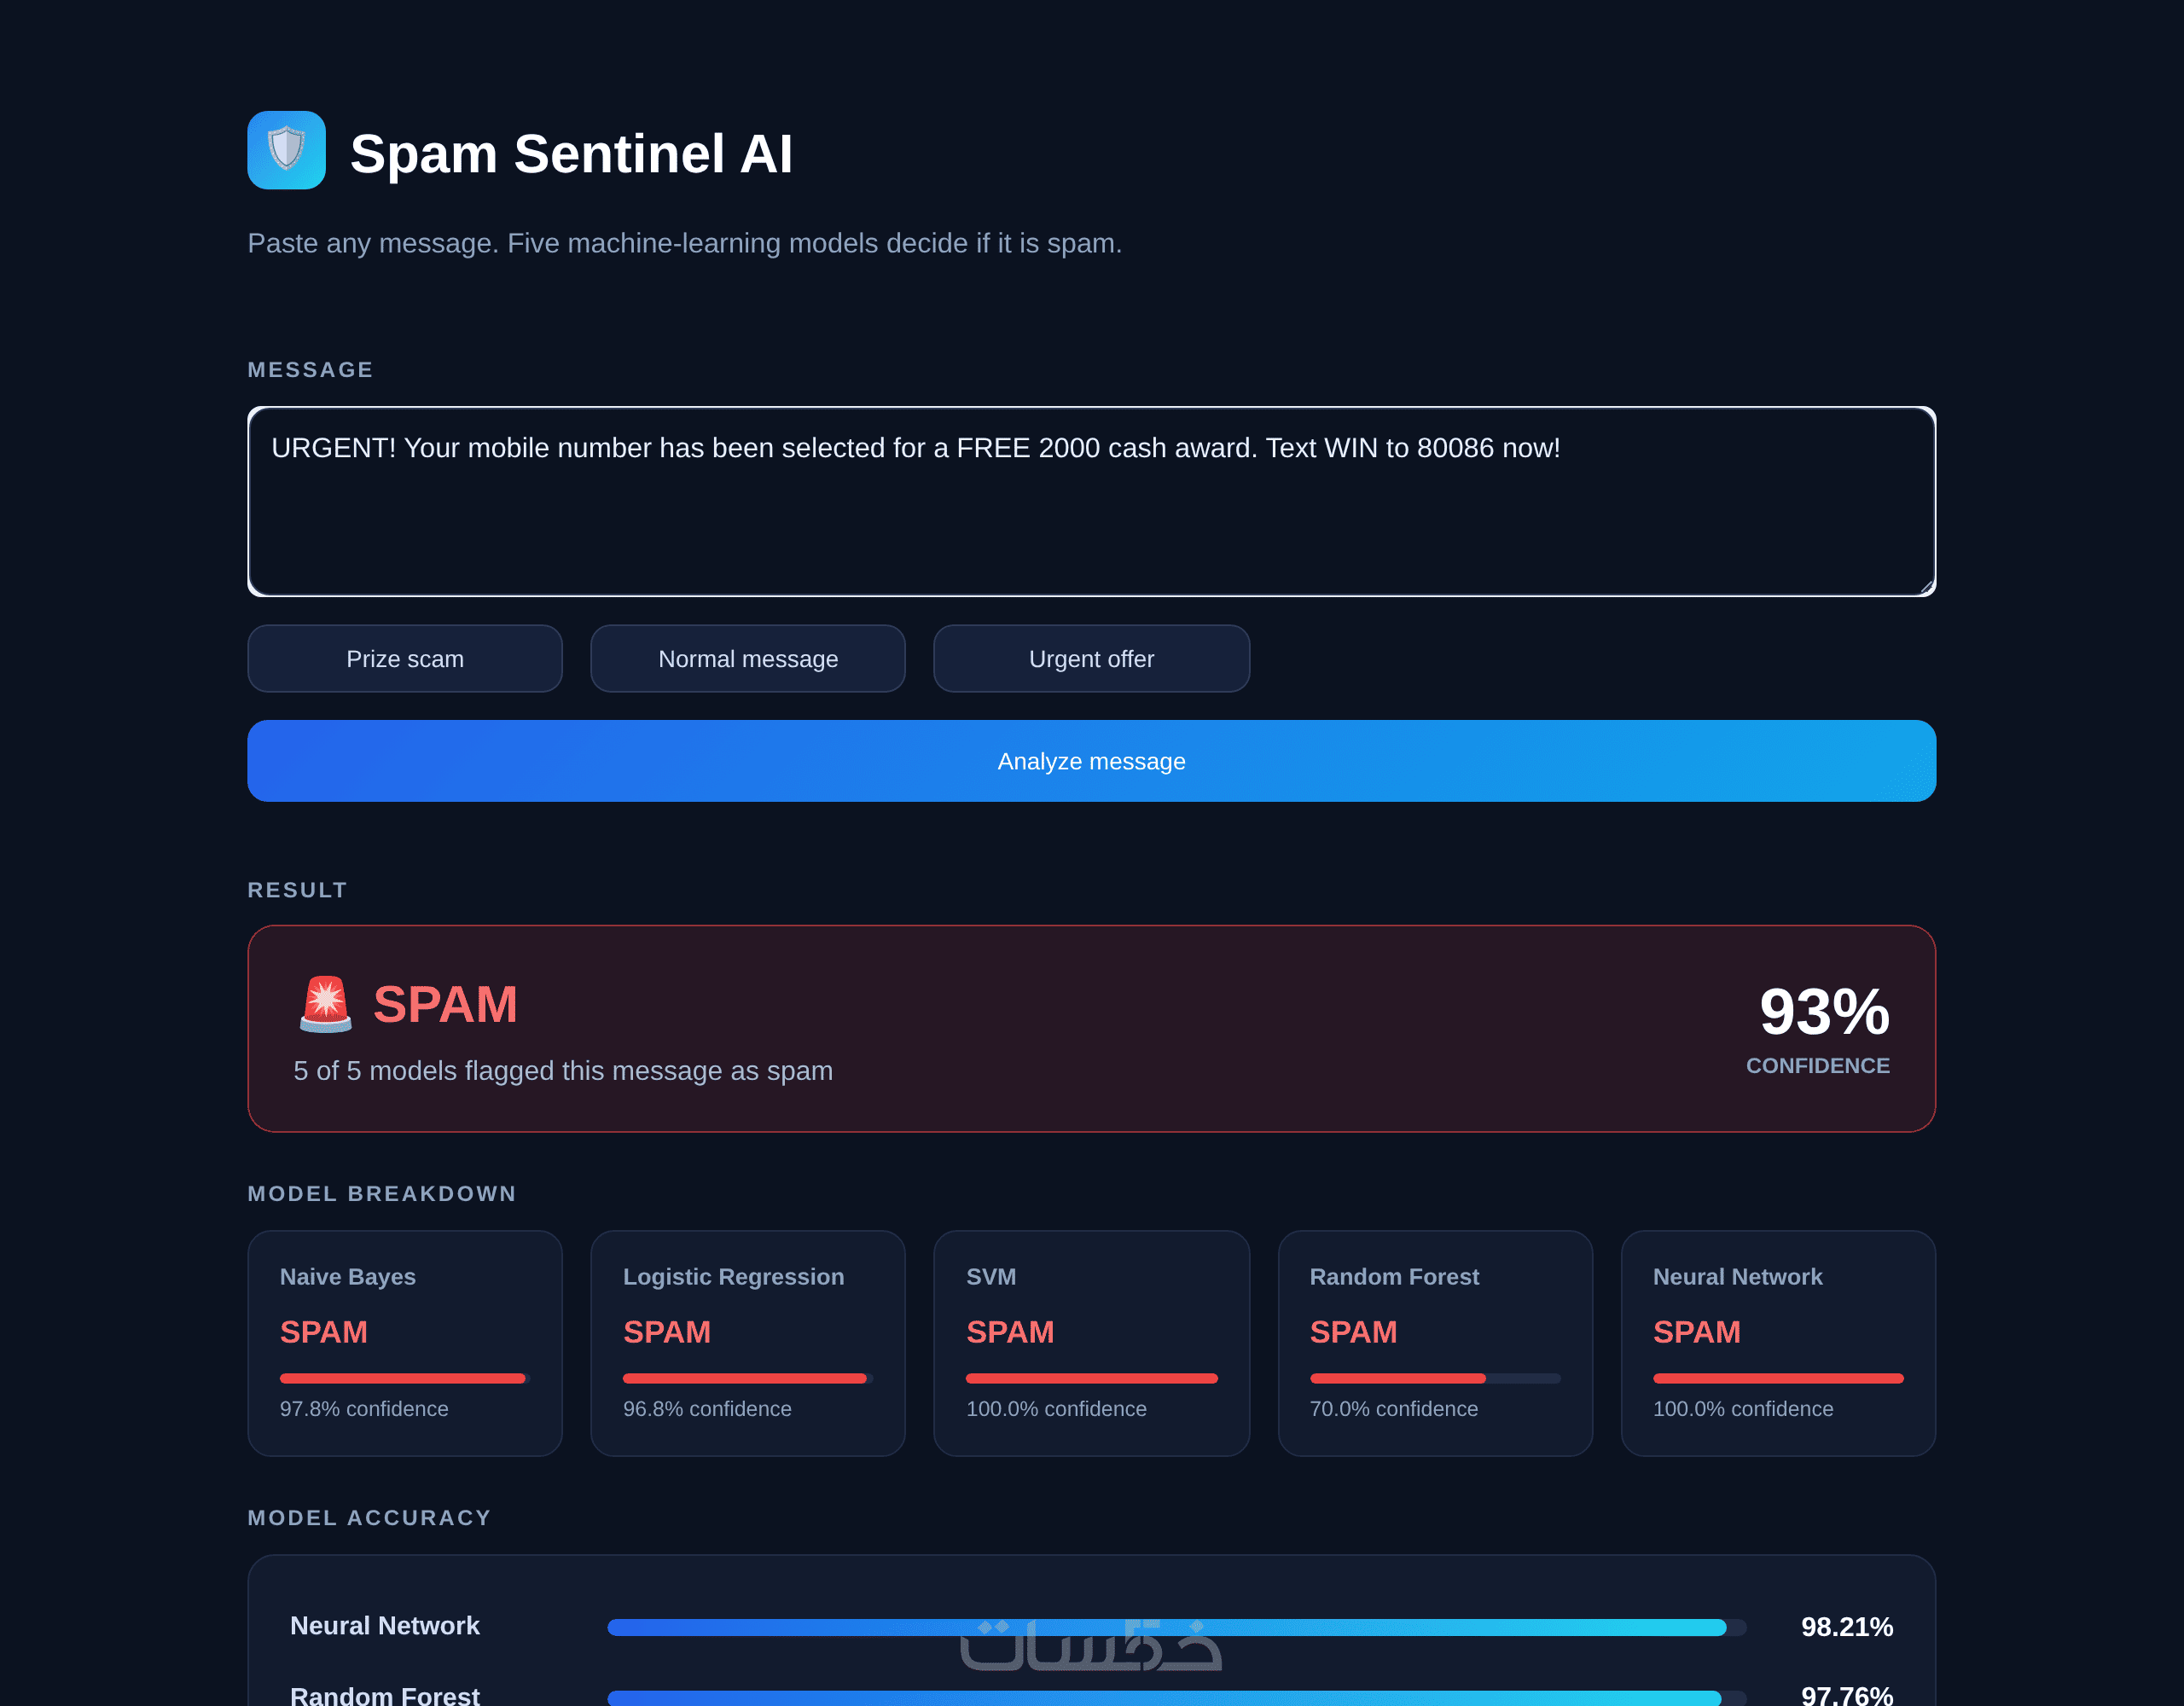
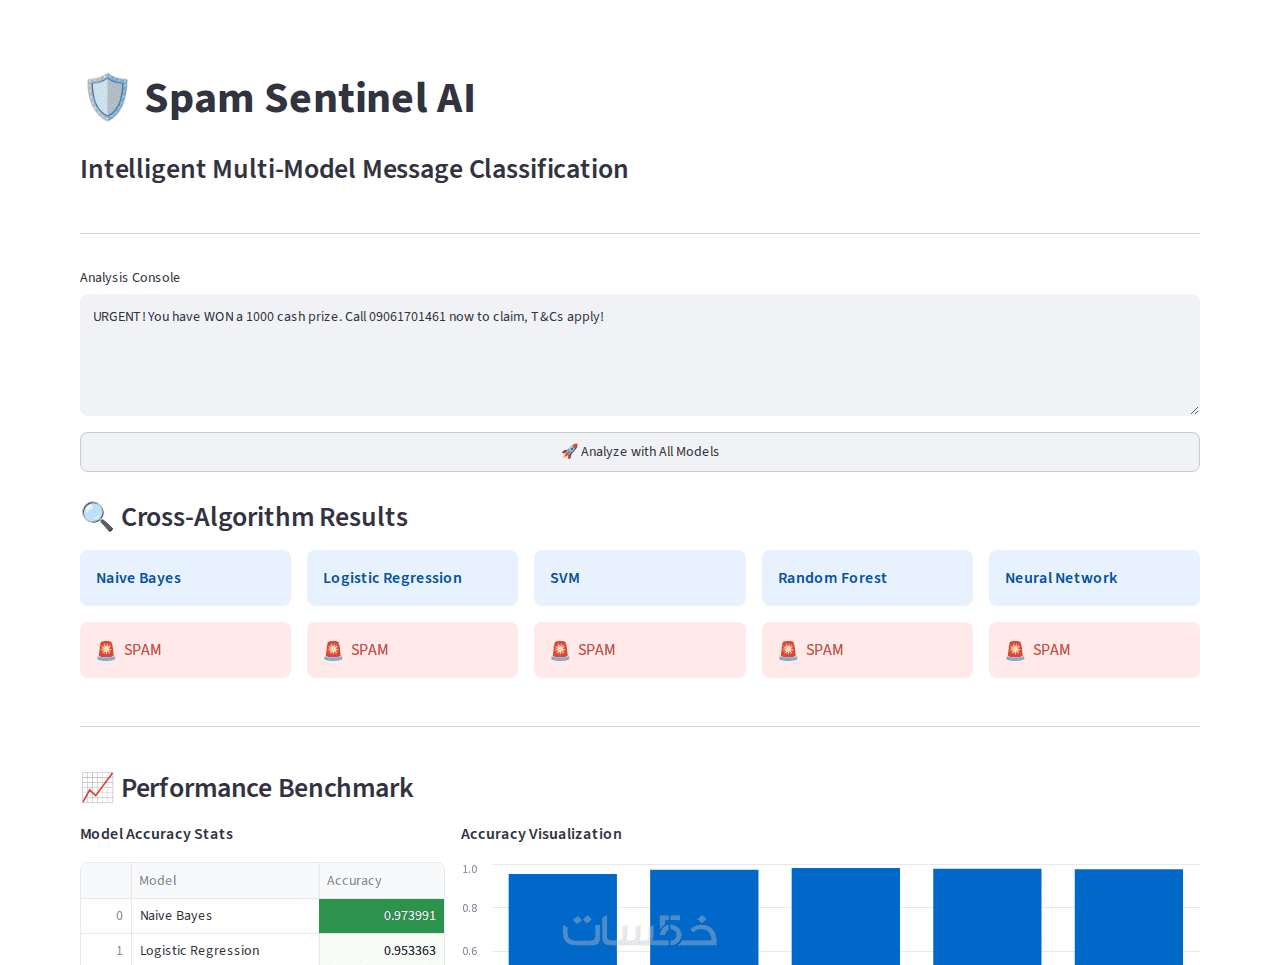
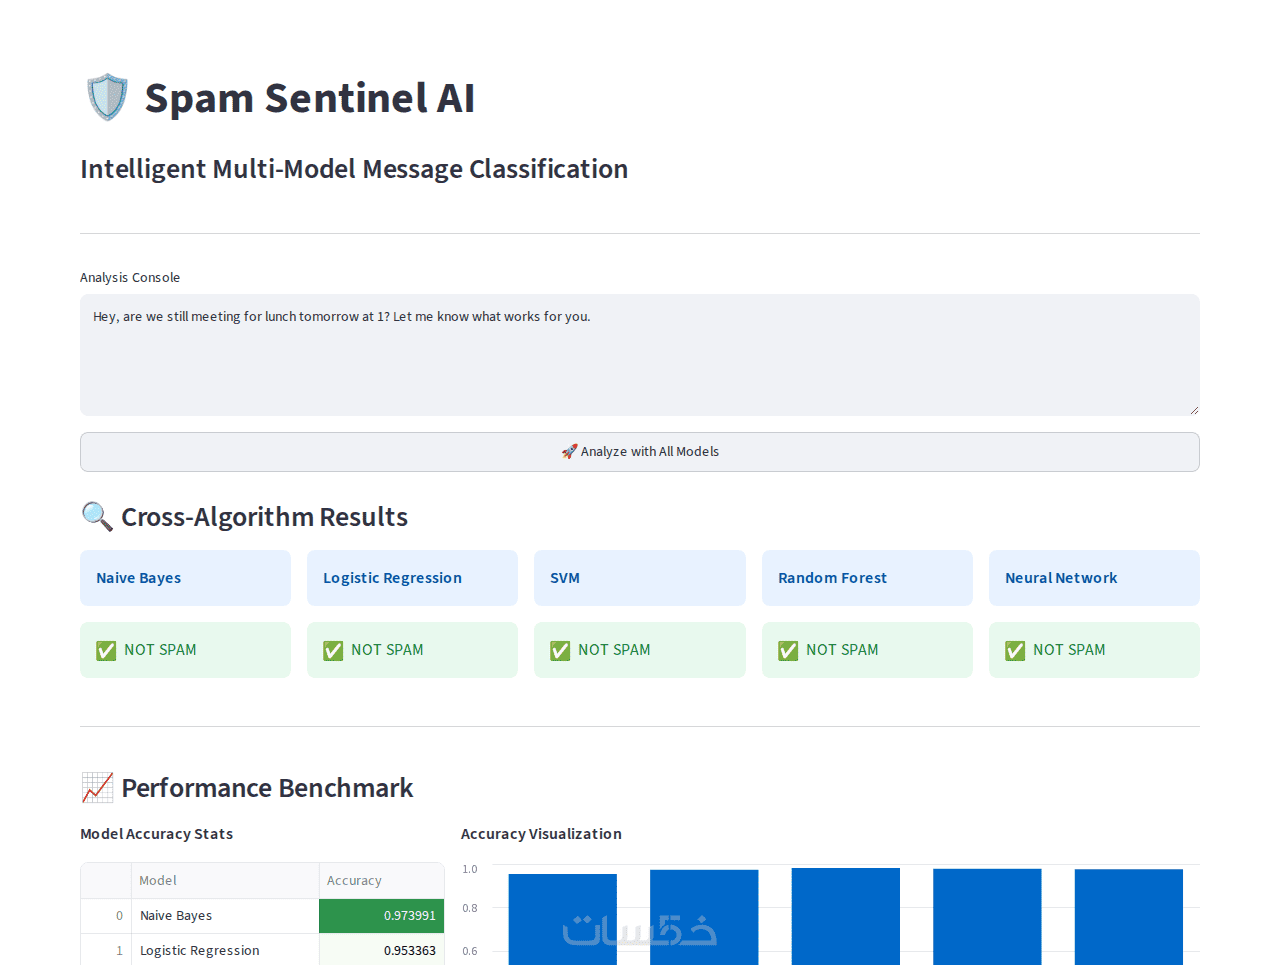
5 موديلات مقارنة
Naive Bayes، Logistic Regression، SVM، Random Forest، Neural Network
نتيجة واضحة فورية
نتيجة واضحة فورية: SPAM أو NOT SPAM
نسبة ثقة للنتيجة النهائية ولكل موديل لوحده
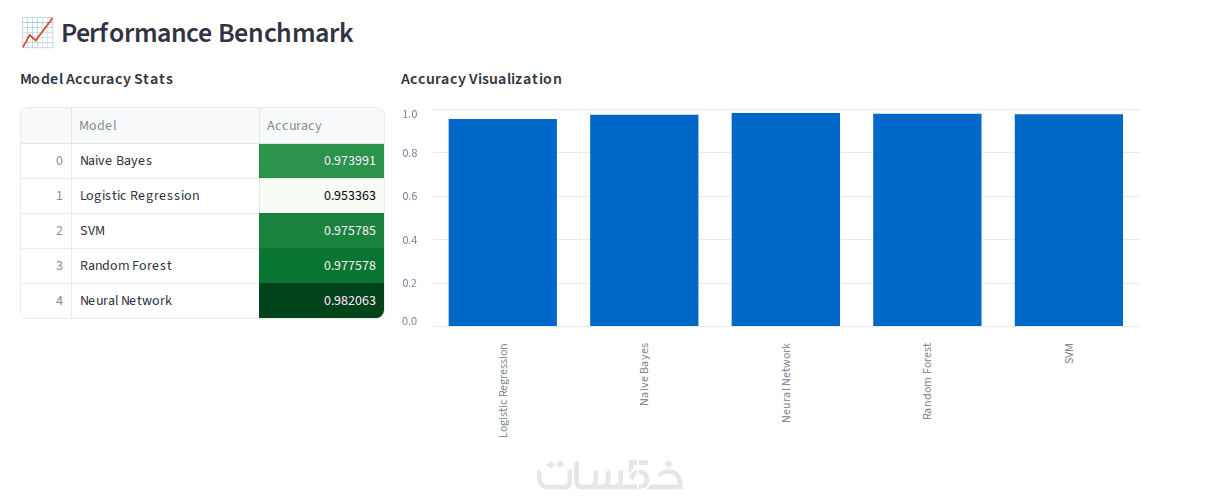
دقة الموديلات من 95.34% لـ 98.21%
واجهة عصرية بتصميم غامق ومنظم
أزرار أمثلة جاهزة للتجربة السريعة
رسم يوضح دقة كل موديل
رسم يوضح دقة كل موديل
كود نضيف ومرتب وسهل التعديل
كود نضيف ومرتب وسهل التعديل
بيشتغل على جهازك من غير إنترنت بعد التثبيت
الخدمة الأساسية
نموذج NLP واحد لتصنيف الرسائل (Spam / Not Spam) باستخدام Python، لحد 5,000 رسالة، بلغة واحدة (عربي أو إنجليزي). التسليم: Notebook + النموذج المدرّب + تقرير الدقة (Accuracy و F1).
مدة التنفيذ وعدد التعديلات
المدة: 5 أيام
التعديلات: 1
الخدمات الإضافية (كل واحدة تضيفها لوحدها بسعر)
زيادة عدد الرسائل لأكتر من 5,000
دعم العربي والإنجليزي معاً
استخدام BERT لدقة أعلى
واجهة تجريبية بسيطة باستخدام Streamlit
تسليم سريع خلال يومين
ما الذي ستستلمه
ما الذي ستستلمه
ملف التطبيق app.py (الواجهة)
الموديلات المدربة all_models.pkl والمحوّل tfidf.pkl
كود التدريب train.py
الداتا spam.csv
ملف model_results.csv بنتايج الدقة
ملف requirements.txt لتثبيت المكتبات
شرح مختصر لطريقة التشغيل (أمر واحد: streamlit run app.py)
كلمات مفتاحية
خدمات قد تنال إعجابك


طلب الخدمة
سعر الخدمة
$5.00
خدمات قد تنال إعجابك
كلمات مفتاحية