خدمة احترافية لتنظيف البيانات Data Preprocessing
خدمة احترافية لتنظيف البيانات Data Preprocessing
وصف الخدمة
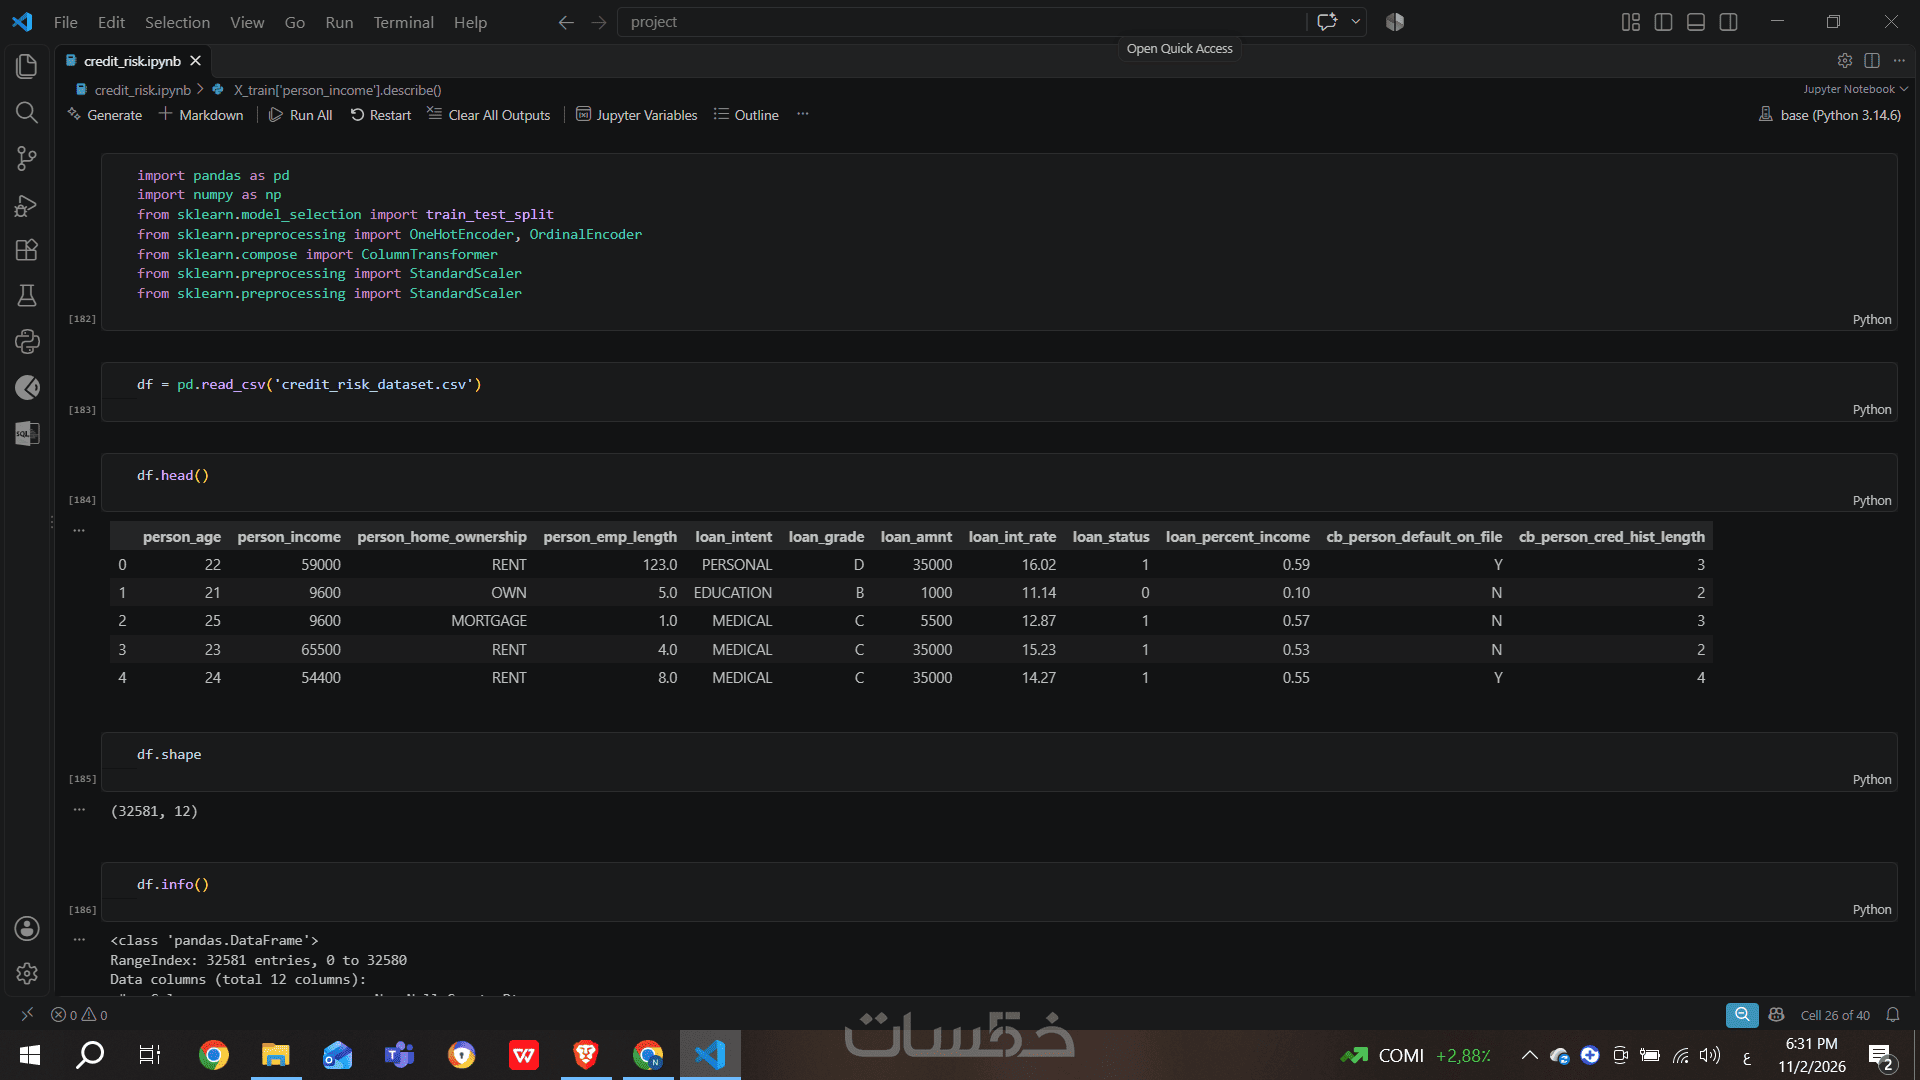
تقديم خدمة احترافية لتنظيف، تجهيز، وهندسة البيانات (Data Preprocessing) لكون جاهزة تمامًا لبناء نماذج التعلم الآلي وعلم البيانات بكفاءة عالية باستخدام لغة Python.
تقسيم البيانات (Train/Test Split):
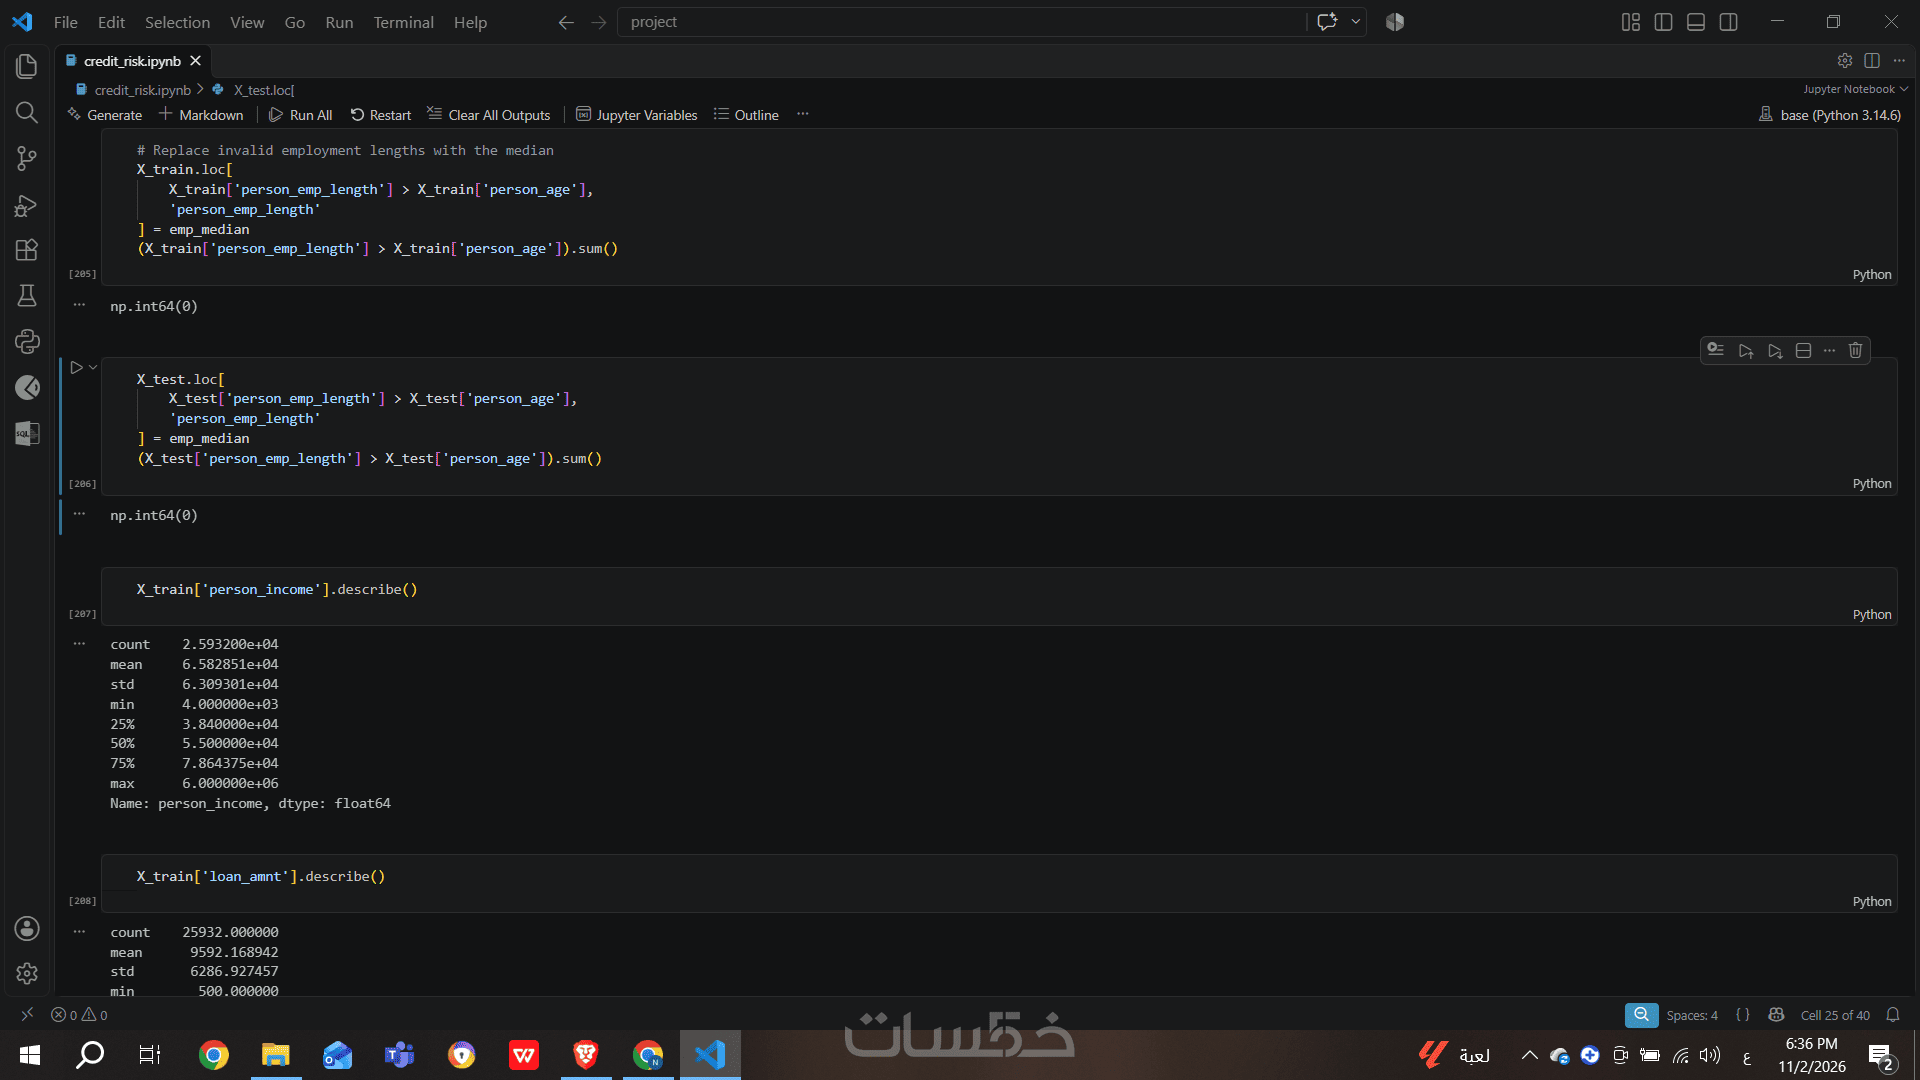
تقسيم البيانات بشكل صحيح ومتقن إلى مجموعتي تدريب واختبار (X_train, X_test, y_train, y_test) لضمان تقييم النموذج بشكل عادل وتجنب مشكلة تسريب البيانات (Data Leakage).
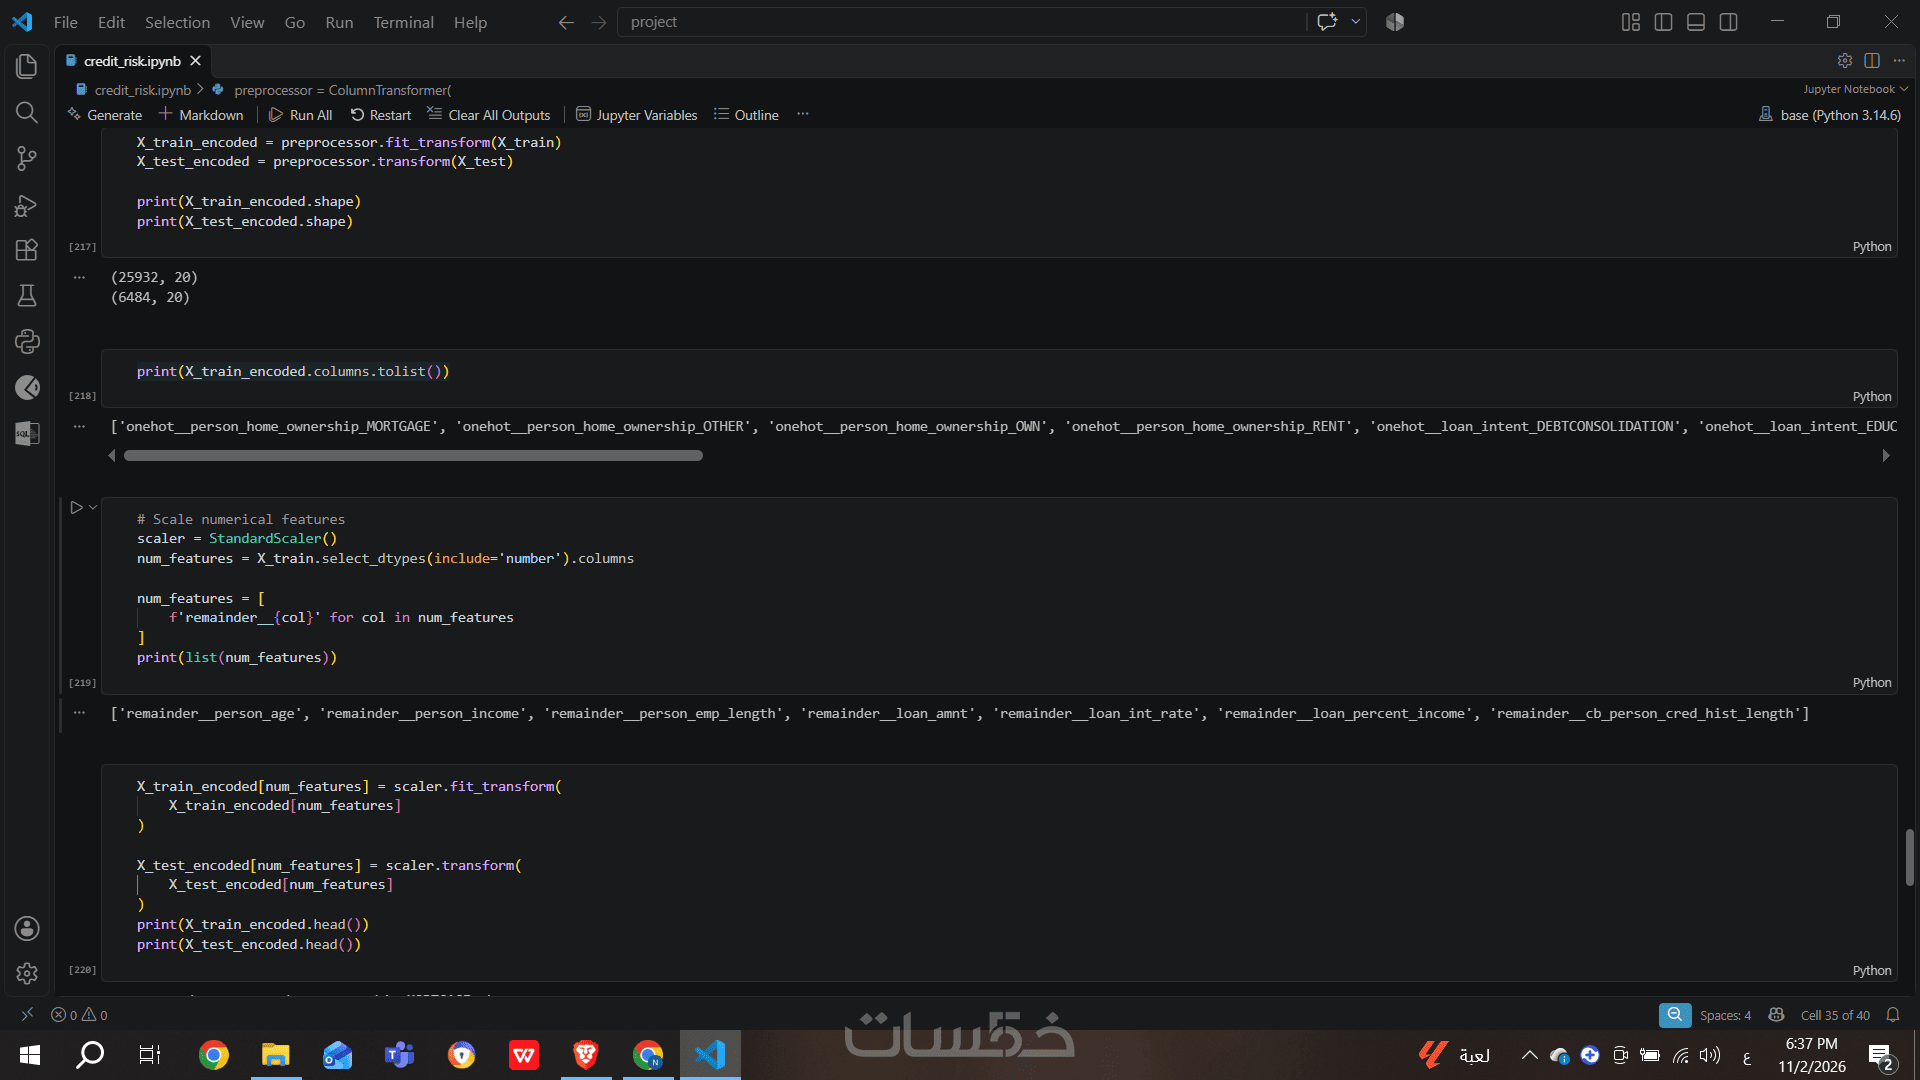
استخدام StandardScaler لتوحيد مقياس المتغيرات الرقمية، مما يضمن تقارب النطاقات وتحسين أداء خوارزميات لتعلم الآلة.
يتم استلام البيانات بصيغ CSV أو Excel أو JSON ويدعم المشروع بيانات يتراوح حجمها من 500 إلى 20000 صف.
مميزات الخدمة
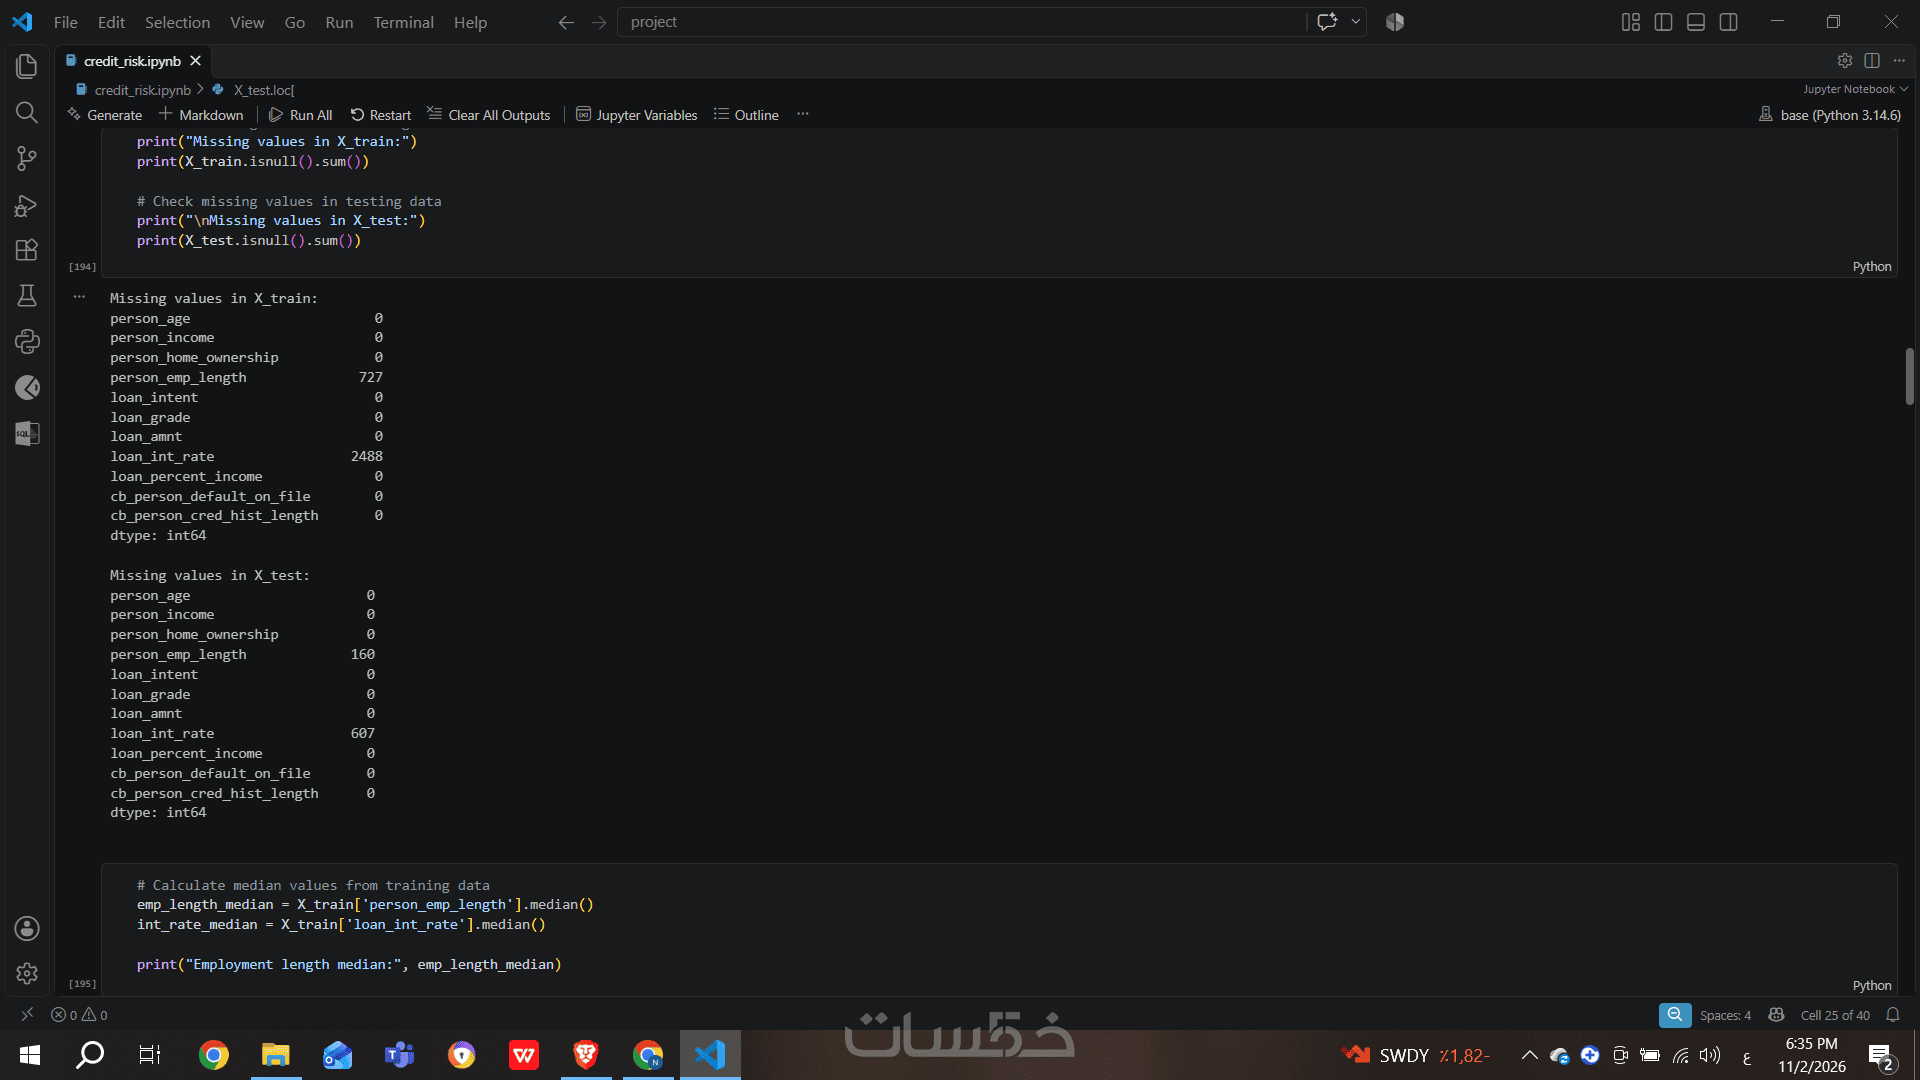
معالجة القيم المفقودة
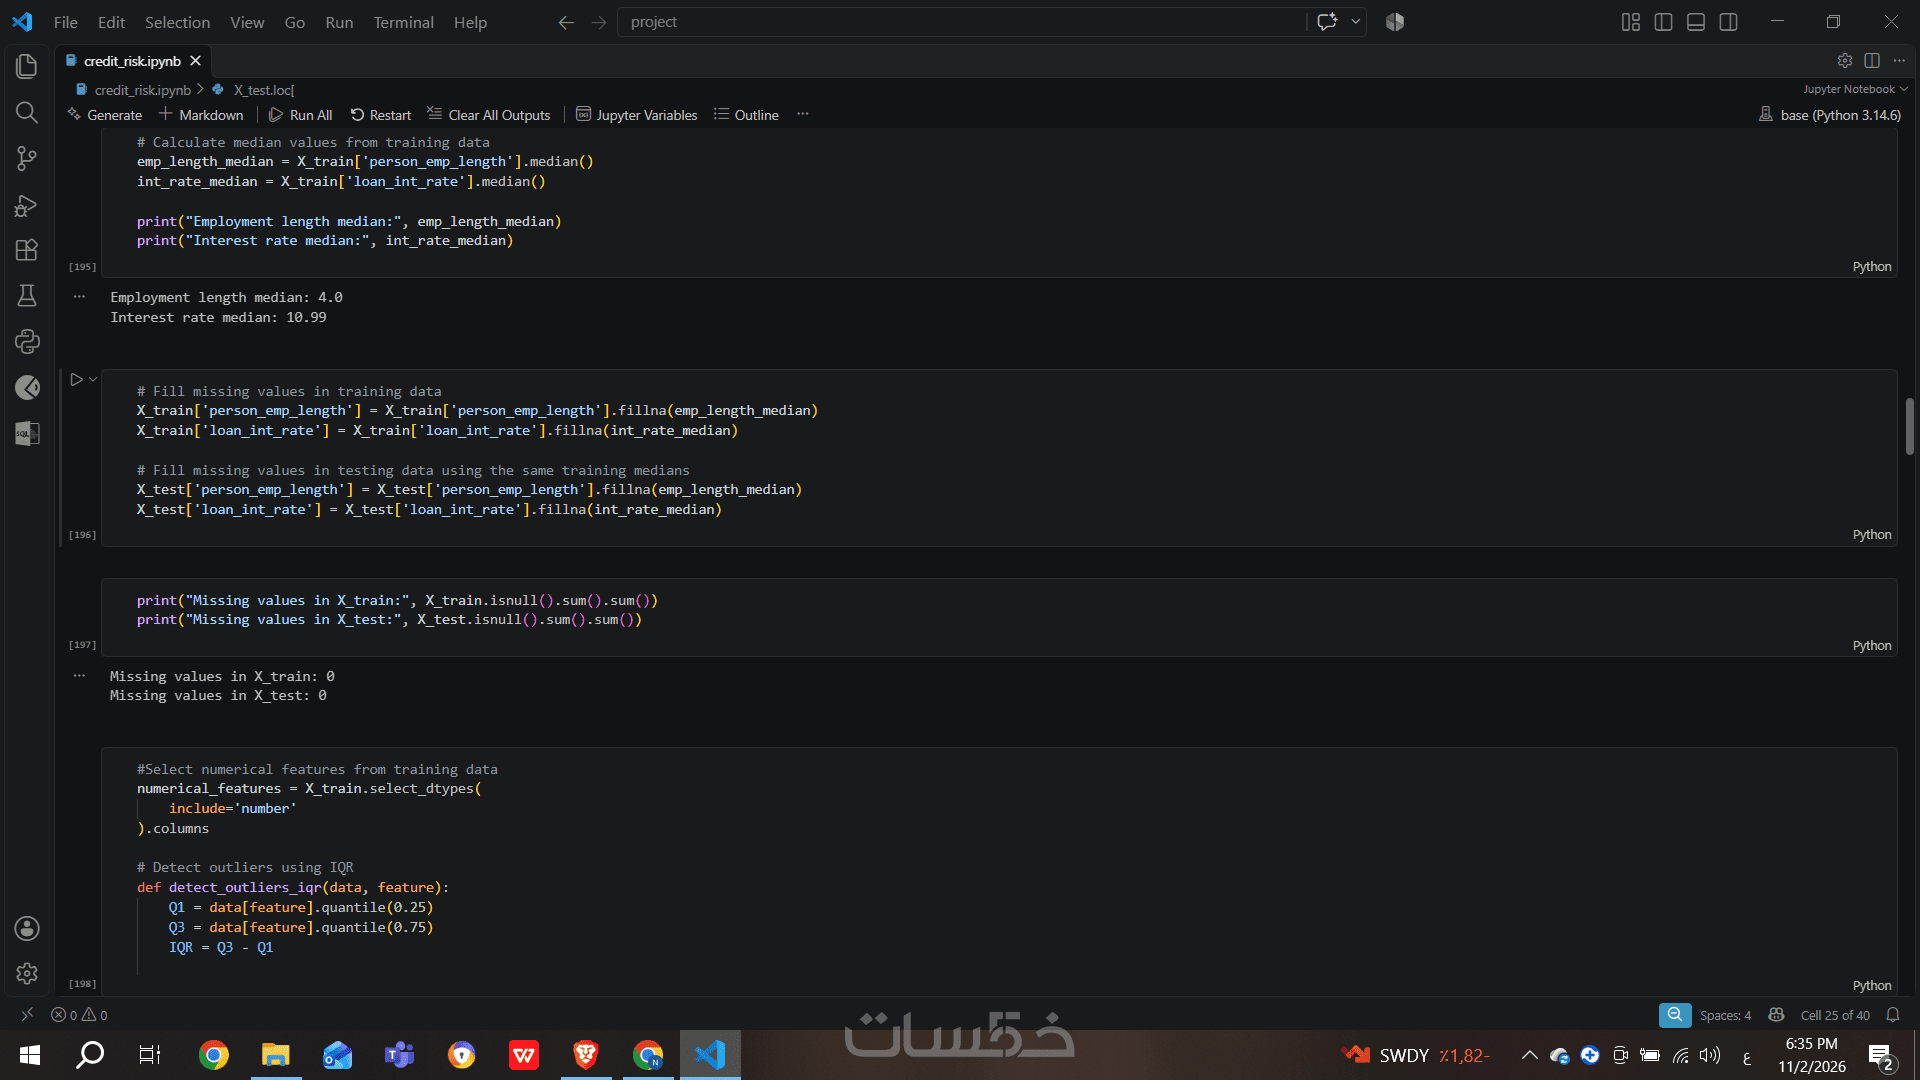
التعامل الذكي مع القيم المفقودة (NaN) في المتغيرات الرقمية والفئوية لضمان نظافة البيانات بنسبة 100%.
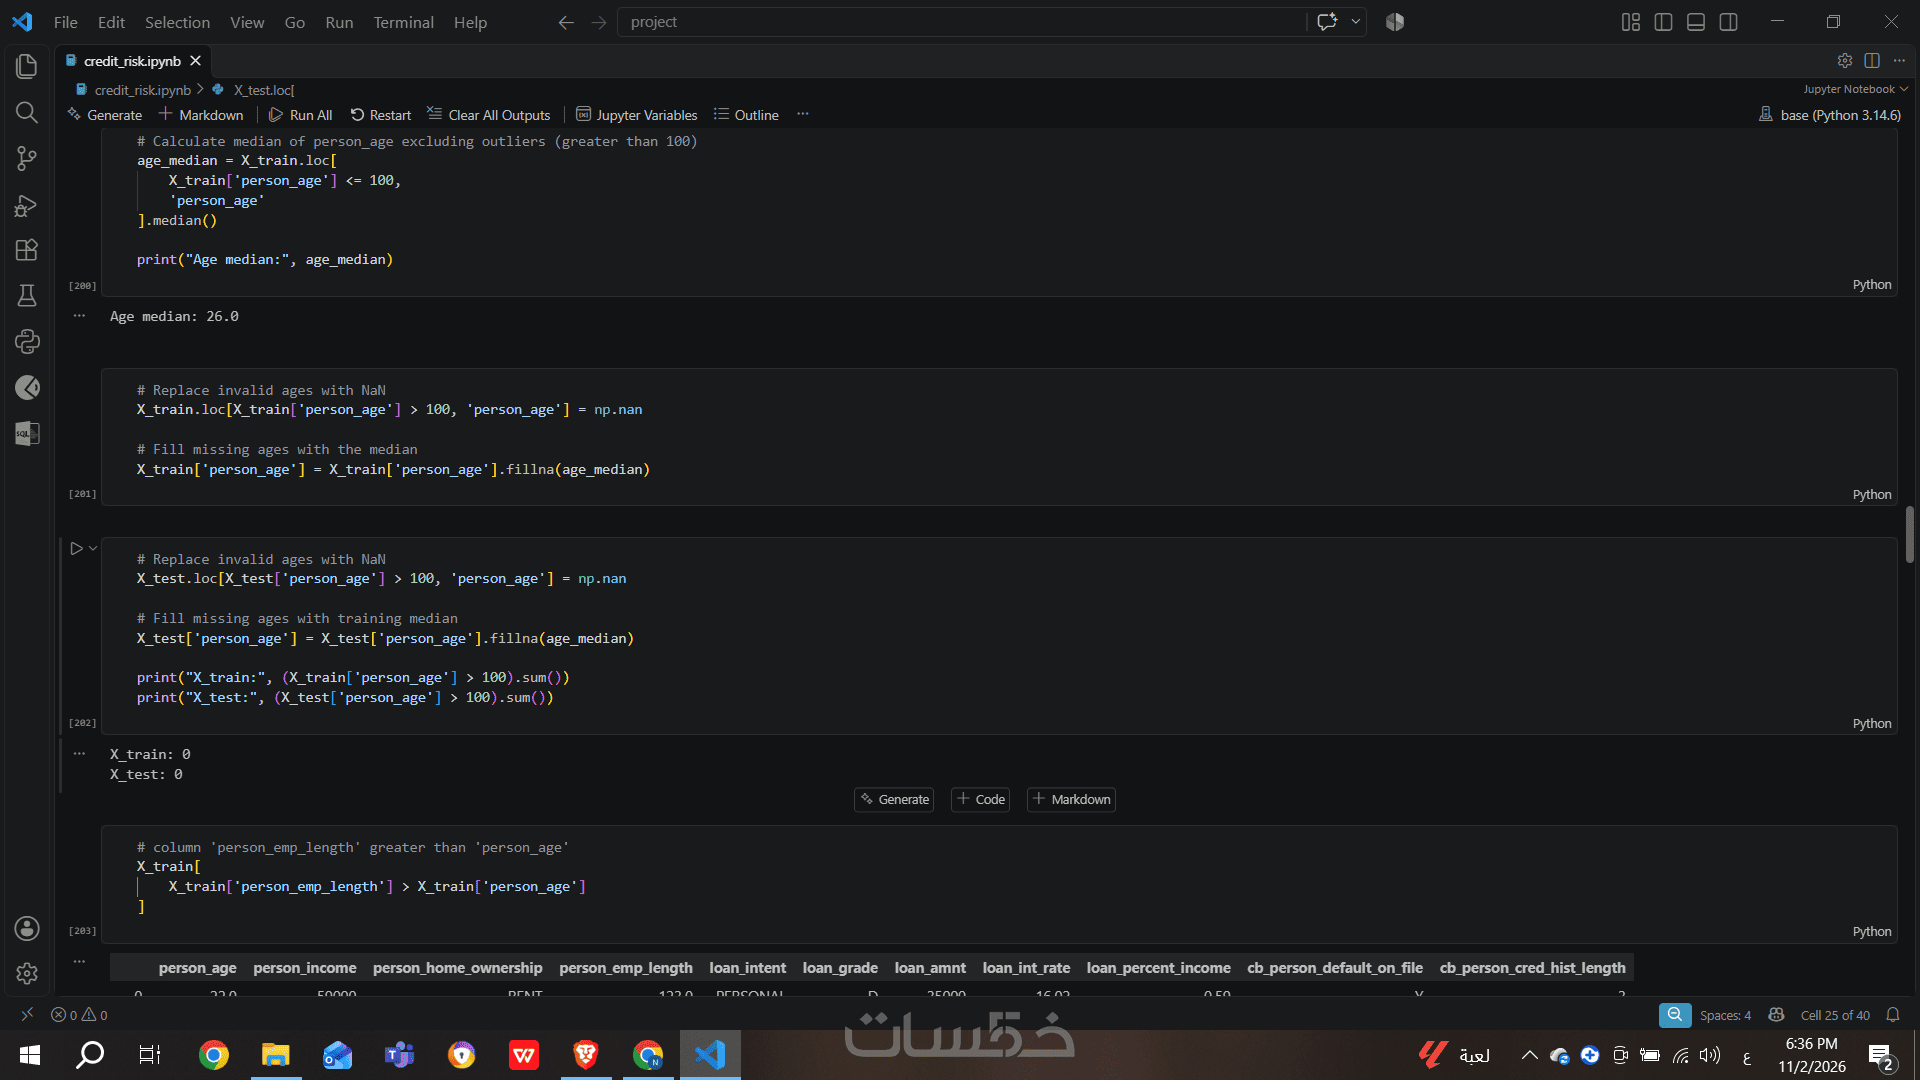
اكتشاف القيم الشاذة (Outliers)
رصد القيم المتطرفة ومعالجتها بحذر لرفع دقة وجودة البيانات قبل النمذجة.
ترميز المتغيرات الفئوية (Encoding)
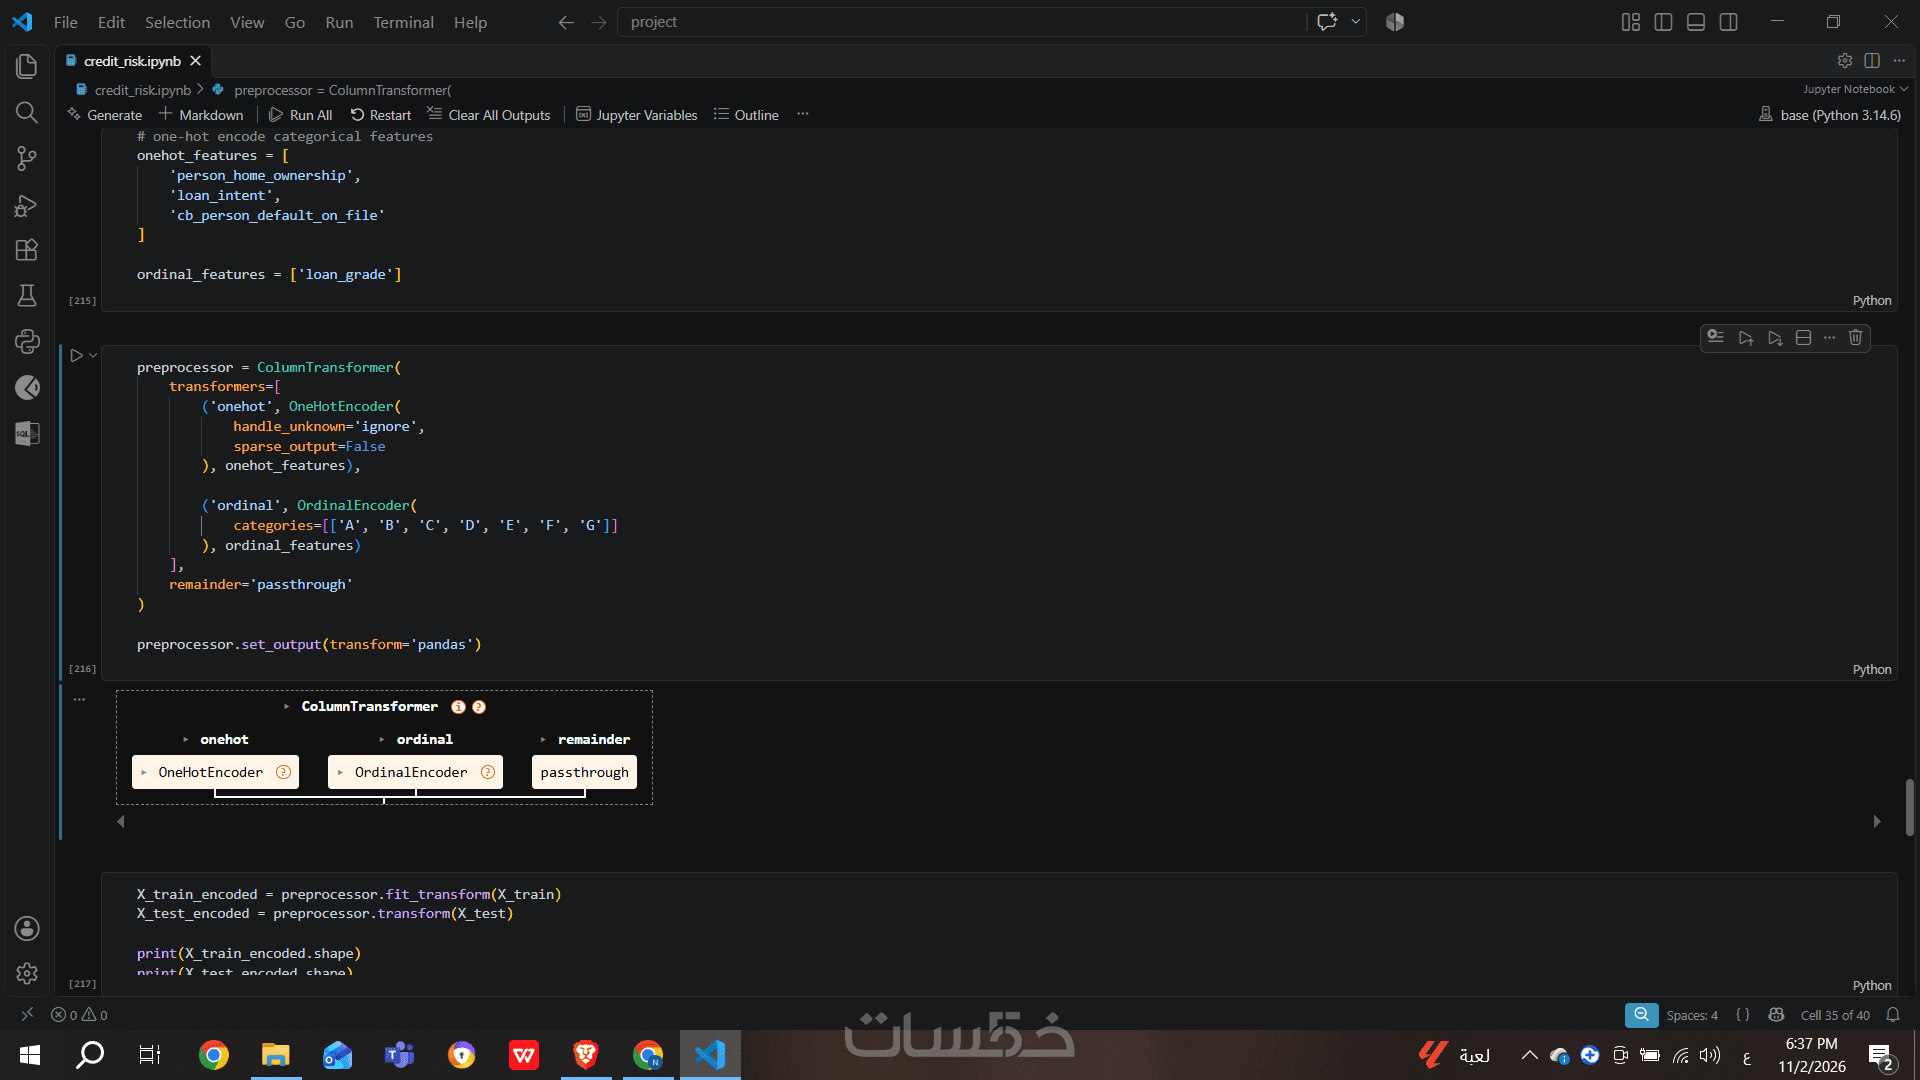
تحويل البيانات النصية والفئوية إلى صيغ عددية صالحة للنمذجة باستخدام أحدث تقنيات Python.
مطابقة الخصائص (Feature Alignment)
ضمان تطابق الأعمدة بين بيانات التدريب والاختبار لتجنب أخطاء البرمجة.
ما الذي ستستلمه
ملف Jupyter Notebook (.ipynb) أو سكربت Python (.py)
منظم بالكامل ومعلق عليه لتوضيح كل خطوة برمجية.
كود نظيف واحترافي
لمعالجة القيم المفقودة (Missing Values) في المتغيرات الرقمية والفئوية.
معالجة القيم الشاذة (Outliers Detection & Capping) لرفع جودة البيانات.
تنفيذ تقنيات ترميز البيانات (Encoding مثل One-Hot Encoding)
ومحاذاة الميزات (Feature Alignment) بين بيانات التدريب والاختبار.
ملف البيانات الناتج (Train/Test)
بعد المعالجة وجاهز مباشرة لمرحلة النمذجة (Model Training).
كلمات مفتاحية
خدمات قد تنال إعجابك




طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
العمل علي بيانات حتي 30000 صف
5.00
|


طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
العمل علي بيانات حتي 30000 صف
5.00
|
خدمات قد تنال إعجابك
كلمات مفتاحية
