معالجة وتنظيف البيانات وتحليلها استكشافياً باستخدام بايثون
معالجة وتنظيف البيانات وتحليلها استكشافياً باستخدام بايثون
وصف الخدمة
هل لديك بيانات غير منظمة، تحتوي على قيم مفقودة، أو ترغب في فهم الأنماط الخفية في بياناتك قبل البدء في تدريب نماذج الذكاء الاصطناعي؟
أقدم لك خدمة احترافية في معالجة وتنظيف البيانات (Data Preprocessing) وتحليلها استكشافياً (Exploratory Data Analysis - EDA) باستخدام أحدث مكتبات بايثون لتجهيز بياناتك وجعلها جاهزة تماماً للتحليل أو بناء النماذج.
مميزات الخدمة
ما الذي تحتويه الخدمة؟
معالجة وتنظيف ملف بيانات واحد (حتى 5,000 سطر أو 15 عموداً).
التعامل مع القيم المفقودة (Missing Values) والبيانات المكررة (Duplicates).
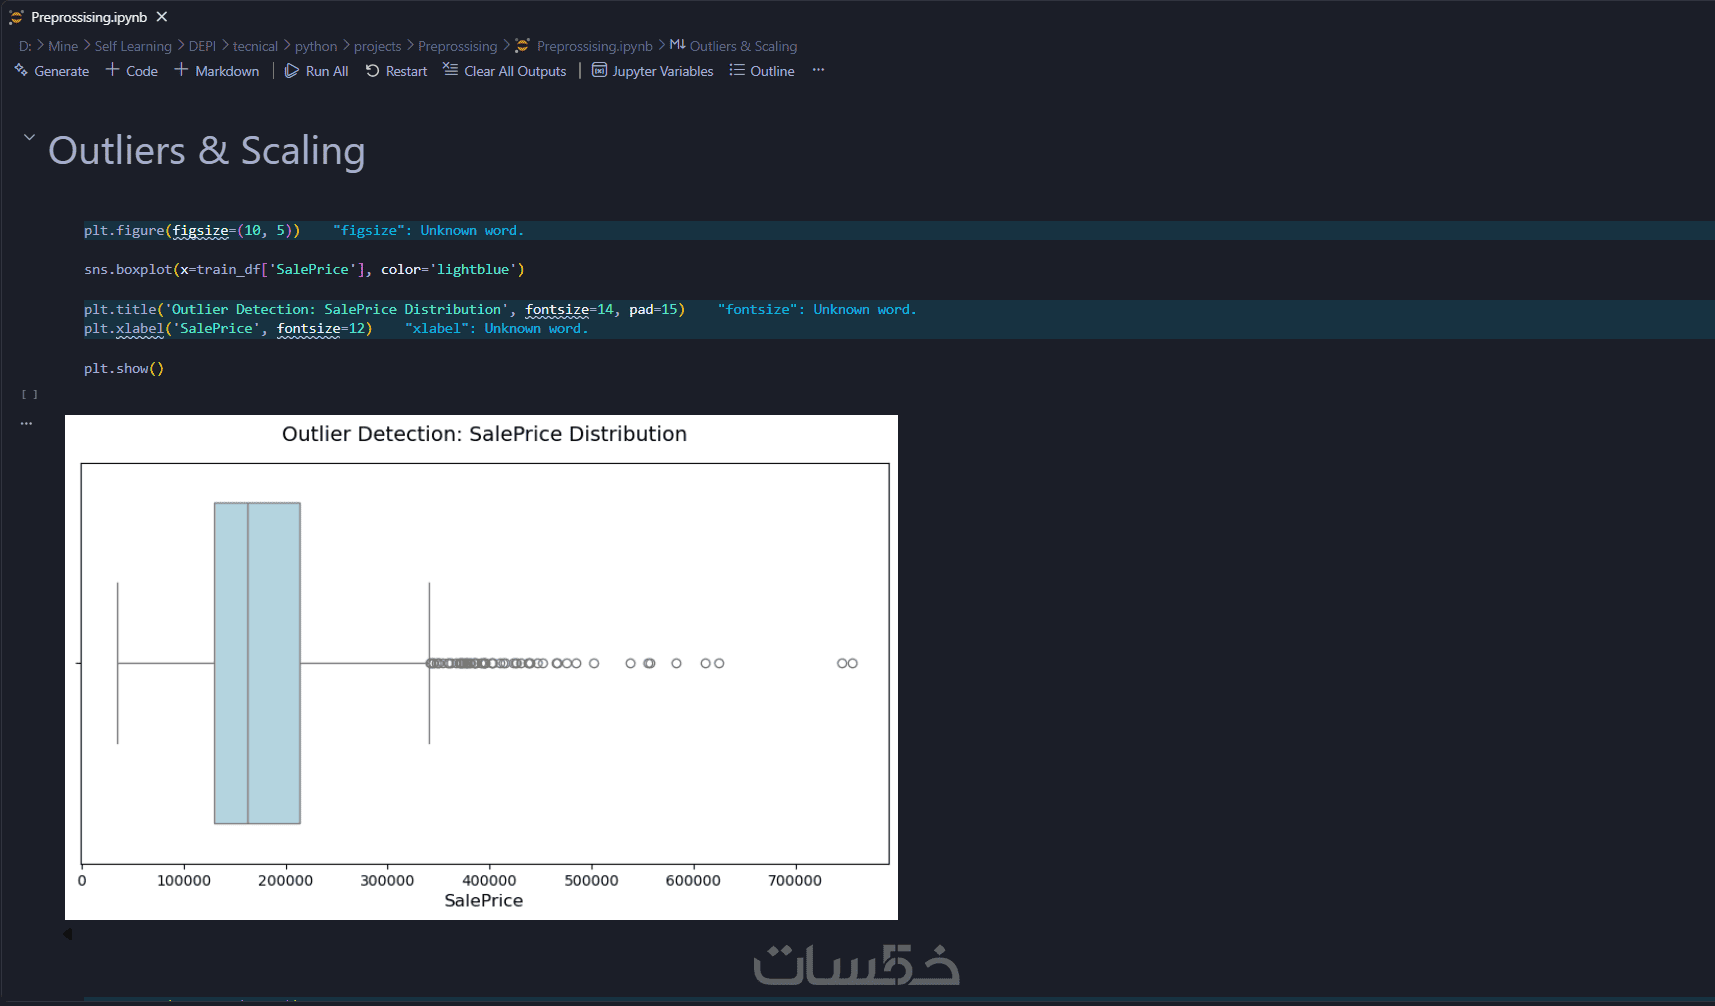
معالجة القيم الشاذة (Outliers) واكتشافها.
تحويل وتنسيق أنواع البيانات (Data Types Alignment).
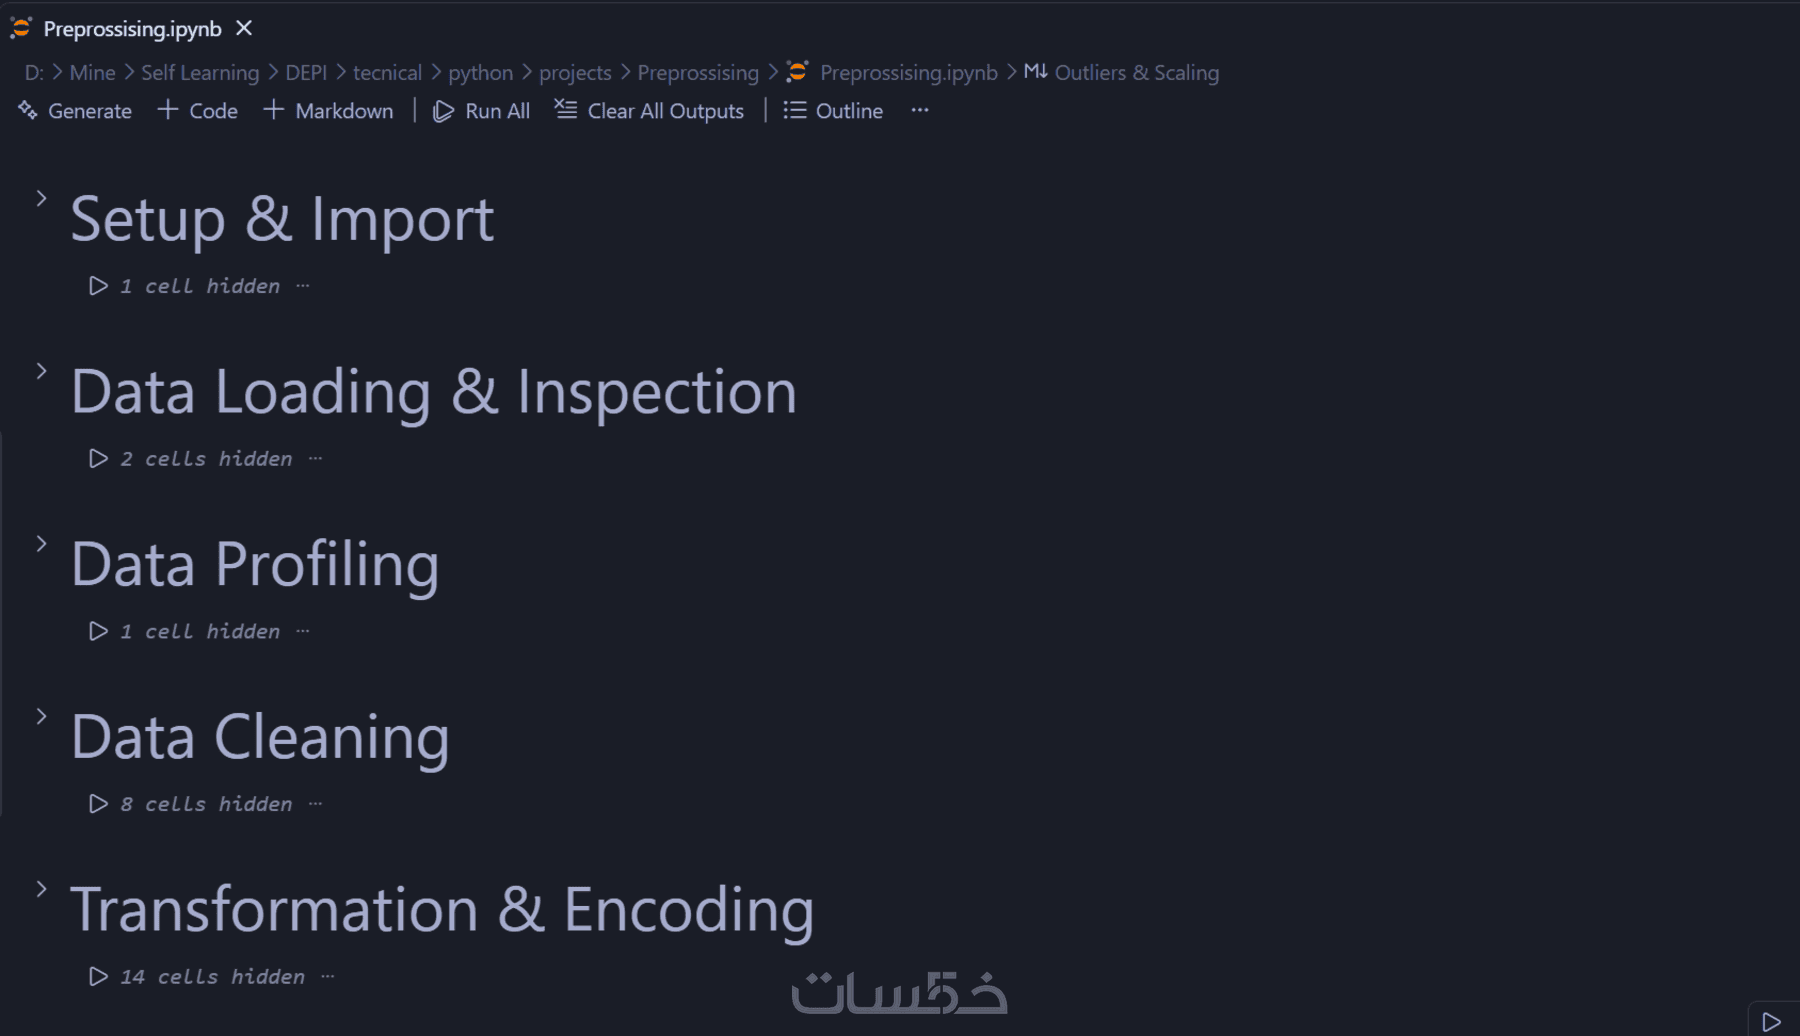
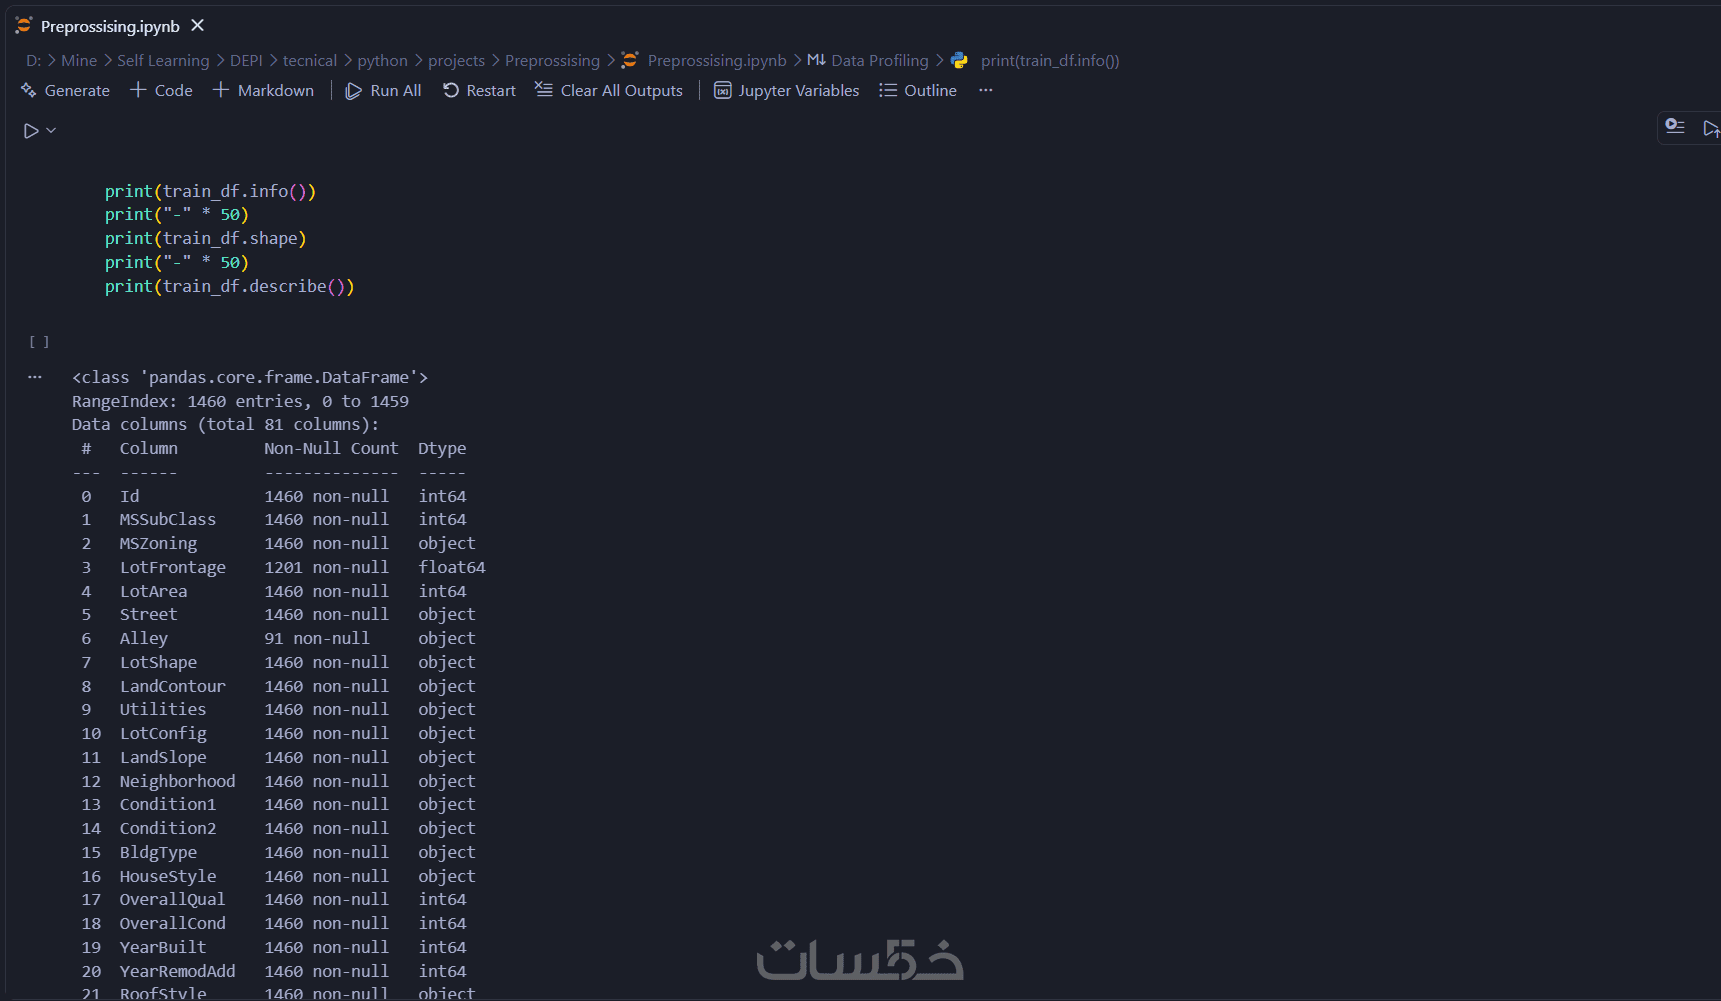
تسليم الكود في ملف Jupyter Notebook (.ipynb) مع تعليقات توضيحية شاملة لكافة الخطوات.
لماذا تختار هذه الخدمة؟
دقة عالية وتنظيم: كتابة كود بايثون نظيف ومعياري (Clean Code) وسهل القراءة.
فهم عميق للبيانات: عدم الاكتفاء بحذف البيانات العشوائية بل اختيار الأسلوب الإحصائي الأنسب لمعالجة كل مشكلة (مثل الـ Imputation الإحصائي).
تسليم الكود كاملاً: يحصل المشتري على كامل الحقوق والكود المصدري لاستخدامه في أي وقت.
مرونة وتواصل: شرح مستمر للخطوات والإجابة عن أي استفسارات تخص البيانات.
الأدوات المستخدمة
Python (اللغة الأساسية)
Pandas & NumPy (لمعالجة الهياكل الرقمية والجداول)
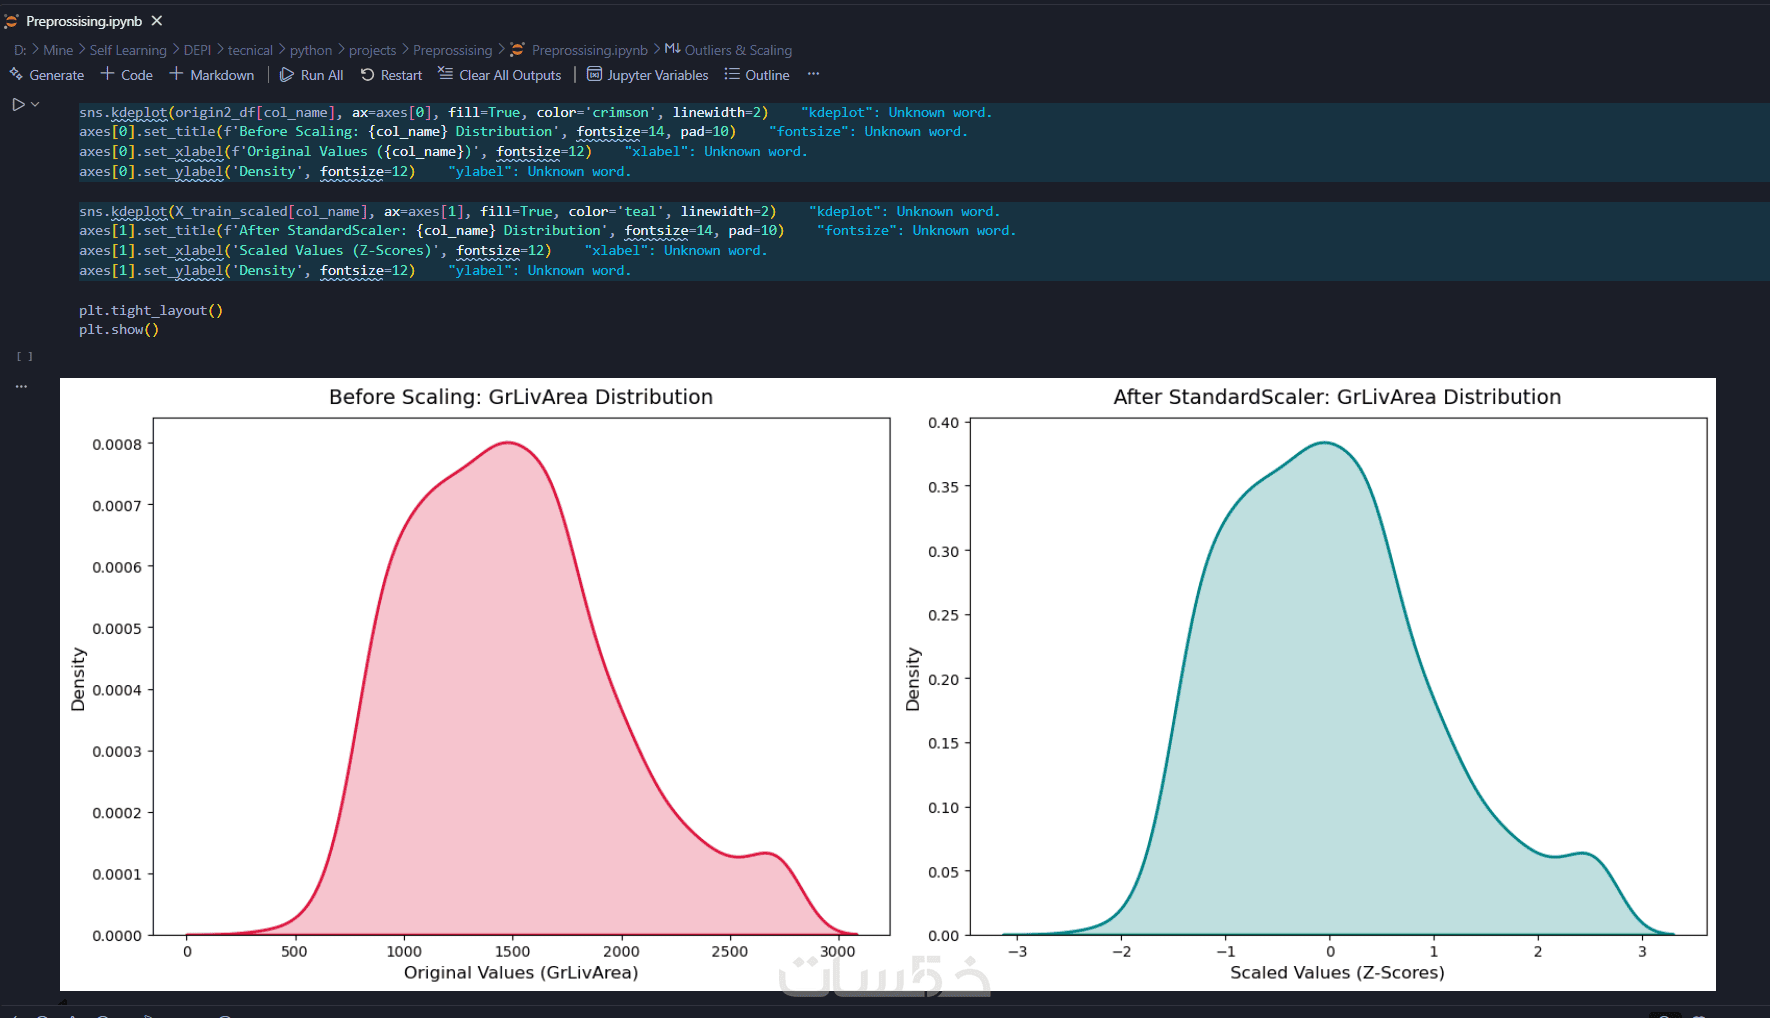
Matplotlib & Seaborn (لإنشاء الرسوم البيانية الاستكشافية)
Jupyter Notebook / VS Code (كتشغيل وتنفيذ مريح وواضح)
ما اريده منك قبل البدء
ملف البيانات: بصيغة (CSV, Excel, JSON, أو SQL dump).
شرح مختصر للمشروع: ما الهدف من البيانات؟ وما هي المتغيرات الأساسية (Target Variable) إن وجدت؟
أي شروط خاصة: (مثل طريقة معينة يفضلها للتعامل مع القيم المفقودة إن وجدت)
ما الذي ستستلمه
ما الذي ستسلمه؟
ملف البيانات المعالجة النظيف: بصيغة CSV أو Excel جاهز للاستخدام المباشر.
ملف الكود المصدري: Jupyter Notebook (.ipynb) منظّم ومقسّم إلى خلايا منطقية ومزود بتعليقات توضيحية.
ملف التقرير (اختياري حسب التطويرات): Rereport أو صور للرسوم البيانية الناتجة من EDA.
كلمات مفتاحية
خدمات قد تنال إعجابك


طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
معالجة ما يصل الي 15,000 سطر او 20 عمودا
10.00
|
|
الوصف: إنشاء من 6 إلى 10 رسوم بيانية تفاعلية وتوضيحية
10.00
|


طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
معالجة ما يصل الي 15,000 سطر او 20 عمودا
10.00
|
|
الوصف: إنشاء من 6 إلى 10 رسوم بيانية تفاعلية وتوضيحية
10.00
|
خدمات قد تنال إعجابك
كلمات مفتاحية
