بناء وتدريب نماذج تعلم الآلة باستخدام بايثون
بناء وتدريب نماذج تعلم الآلة باستخدام بايثون
وصف الخدمة
هل تبحث عن حلول ذكية لتحليل بياناتك وبناء نماذج تنبؤية عالية الدقة؟ أقدم لك خدمة متكاملة في تطوير وتدريب نماذج تعلم الآلة (Machine Learning) بأسلوب عصري وكود احترافي.
نطاق العمل للخدمة الأساسية:
تتضمن الخدمة الأساسية تنفيذ المخرجات التالية على مشروعك:
معالجة وتنظيف البيانات (Data Preprocessing):
تنظيف ملف بيانات حتى 500 سطر و 10 أعمدة (معالجة القيم المفقودة والتكرار، التعامل مع القيم الشاذة Outliers، وتحويل النصوص إلى أرقام Categorical Encoding).
بناء وتدريب وتقييم النموذج:
تدريب خوارزمية واحدة (مثل: Decision Tree أو Logistic Regression أو Random Forest) وتقييم أدائها مع استخراج الرسوم البيانية ومقاييس الأداء (Accuracy & Confusion Matrix).
مميزات الخدمة
معالجة وتجهيز متقدم للبيانات:
تطبيق تقنيات موازنة البيانات (Handling Imbalanced Data) وتحجيم الخصائص (Feature Scaling / Normalization) لرفع كفاءة الخوارزمية وتفادي الانحياز.
ضبط وتعديل المعلمات (Hyperparameter Tuning):
تحسين إعدادات الخوارزمية للوصول لأعلى دقة ممكنة وتجنب مشكلة الإفراط في التعلم (Overfitting).
تحليل بصري وتقارير أداء شاملة:
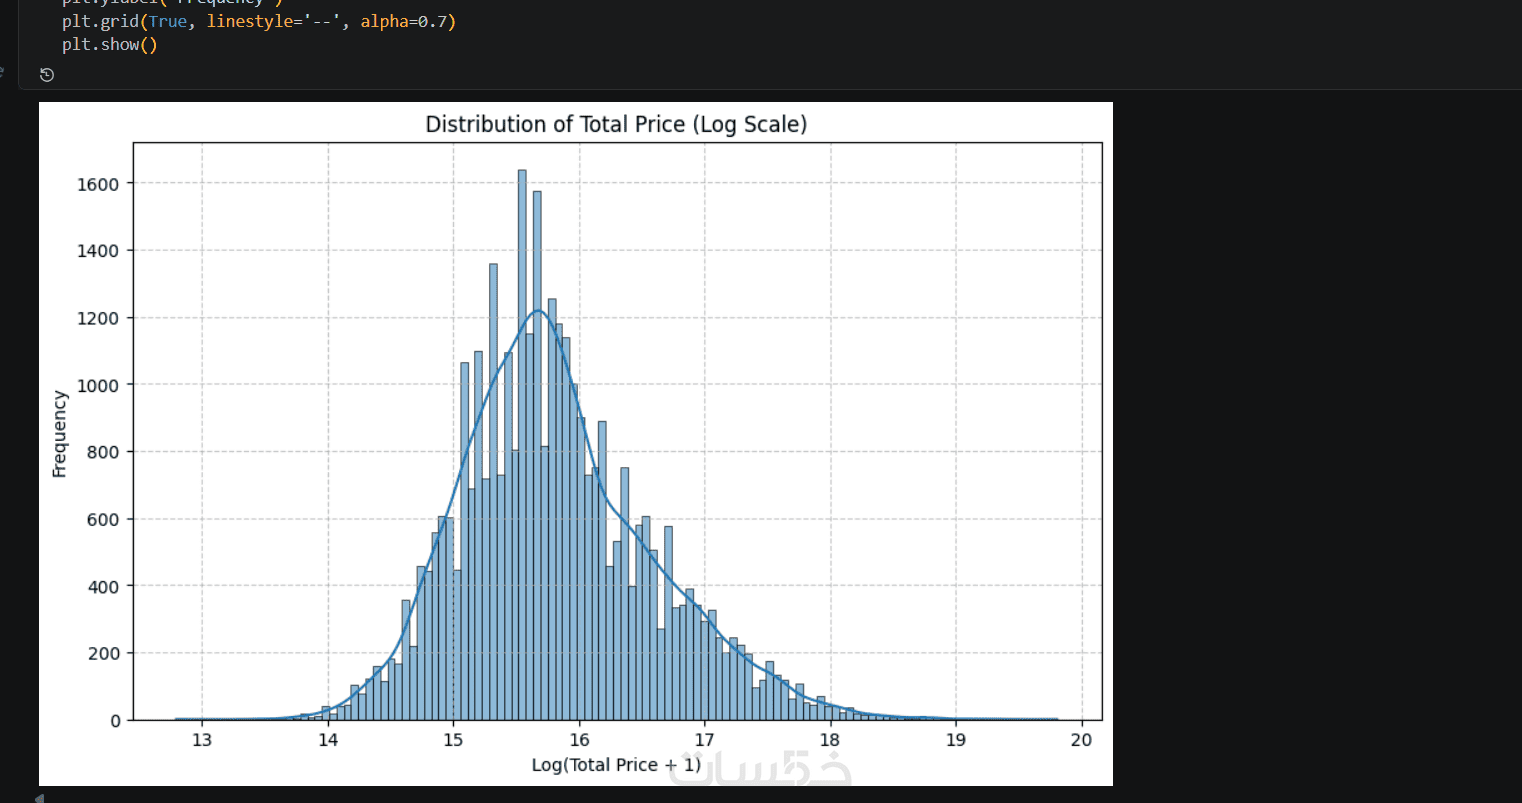
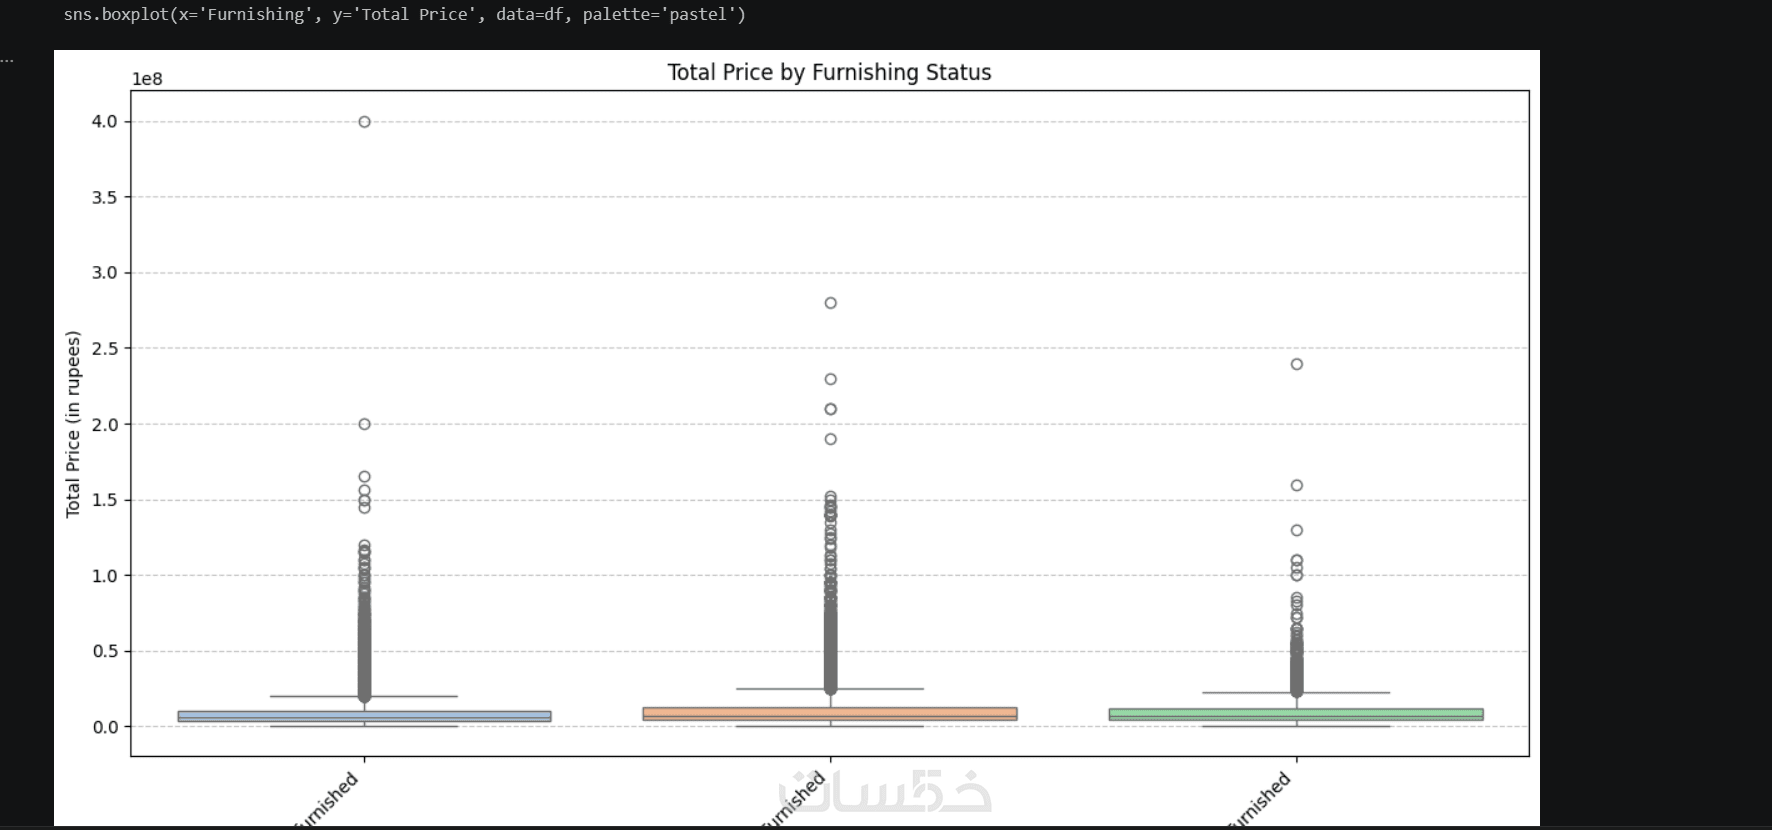
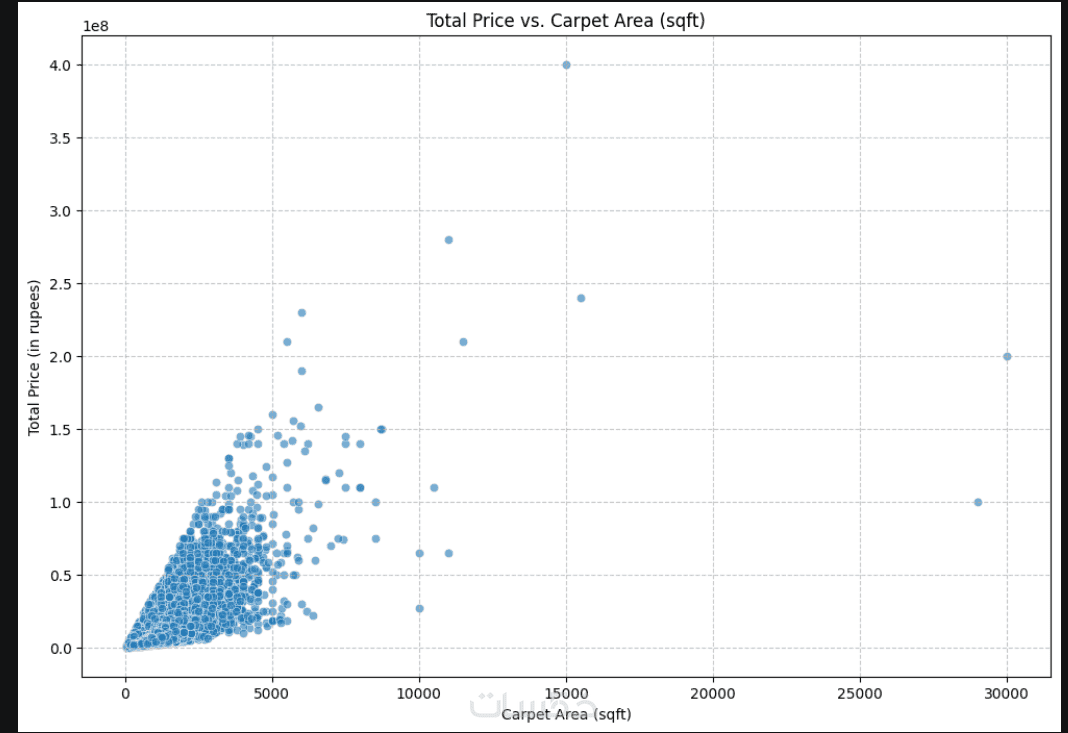
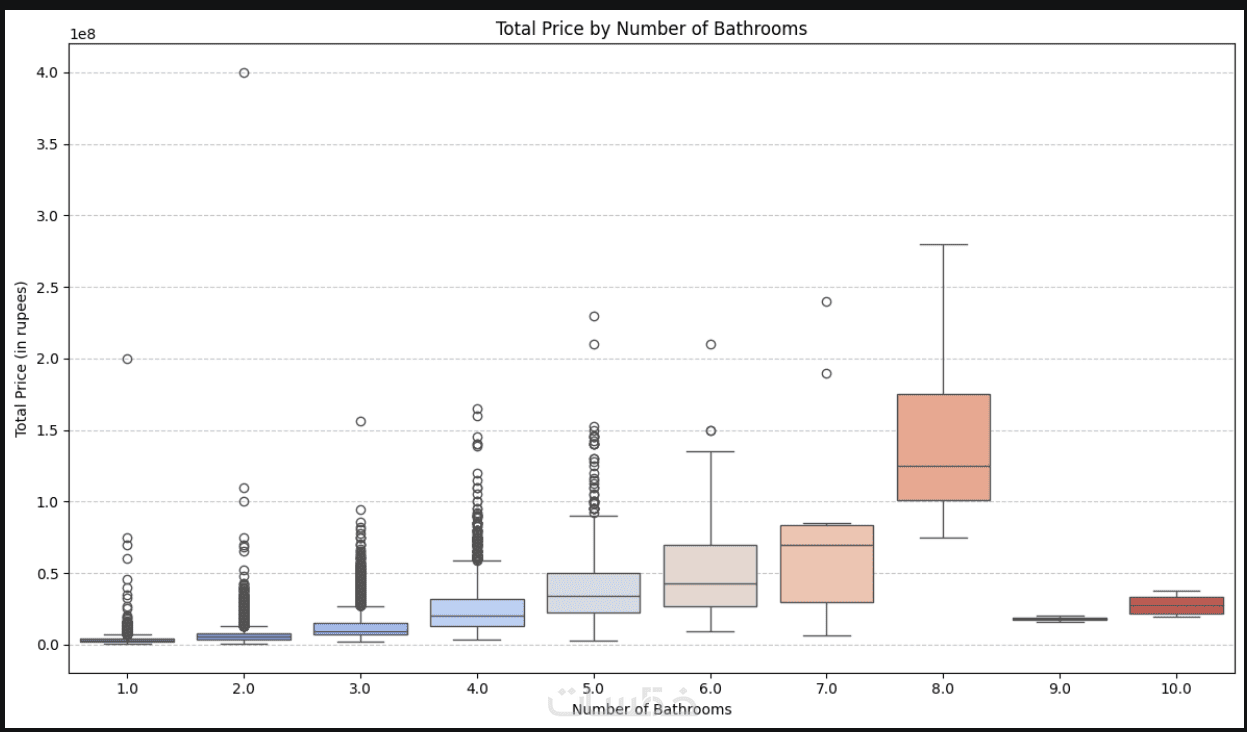
استعراض النتائج ومصفوفات الأداء ورسوم البيانات بشكل مرئي واضح ومُنسّق باستخدام أدوات Seaborn و Matplotlib لسهولة القراءة والاستنتاج.
ما الذي ستستلمه
ملف الكود المصدري الكامل
ملف برمجي بصيغة (.ipynb عبر Jupyter Notebook أو Google Colab) يحتوي على الكود بالكامل جاهزاً للتشغيل المباشر.
تقرير تقييم أداء النموذج
تقرير مختصر يشرح دقة النموذج النتائج المقاسة (Accuracy, Precision, Recall, F1-score) وكيفية عمله.
كلمات مفتاحية
خدمات قد تنال إعجابك



طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
زيادة حجم البيانات الى 5000 سطر
5.00
|
|
شرح الكود و توفير تعليقات مفصلة
10.00
|
|
رفع و تنسيق المشروع على Github
5.00
|
|
لوحة تحاكم تفاعلية متكاملة stremlit
25.00
|


طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
زيادة حجم البيانات الى 5000 سطر
5.00
|
|
شرح الكود و توفير تعليقات مفصلة
10.00
|
|
رفع و تنسيق المشروع على Github
5.00
|
|
لوحة تحاكم تفاعلية متكاملة stremlit
25.00
|
خدمات قد تنال إعجابك
كلمات مفتاحية
