تنفيذ مشاريع تعلم الآلة و تحليل البيانات ML,DATA ANALYSIS
تنفيذ مشاريع تعلم الآلة و تحليل البيانات ML,DATA ANALYSIS
مرحبًا بك، وشكرًا لثقتك!
حجم العمل الأساسي :
معالجة بيانات حتى 50 ألف صف و20 عمود.
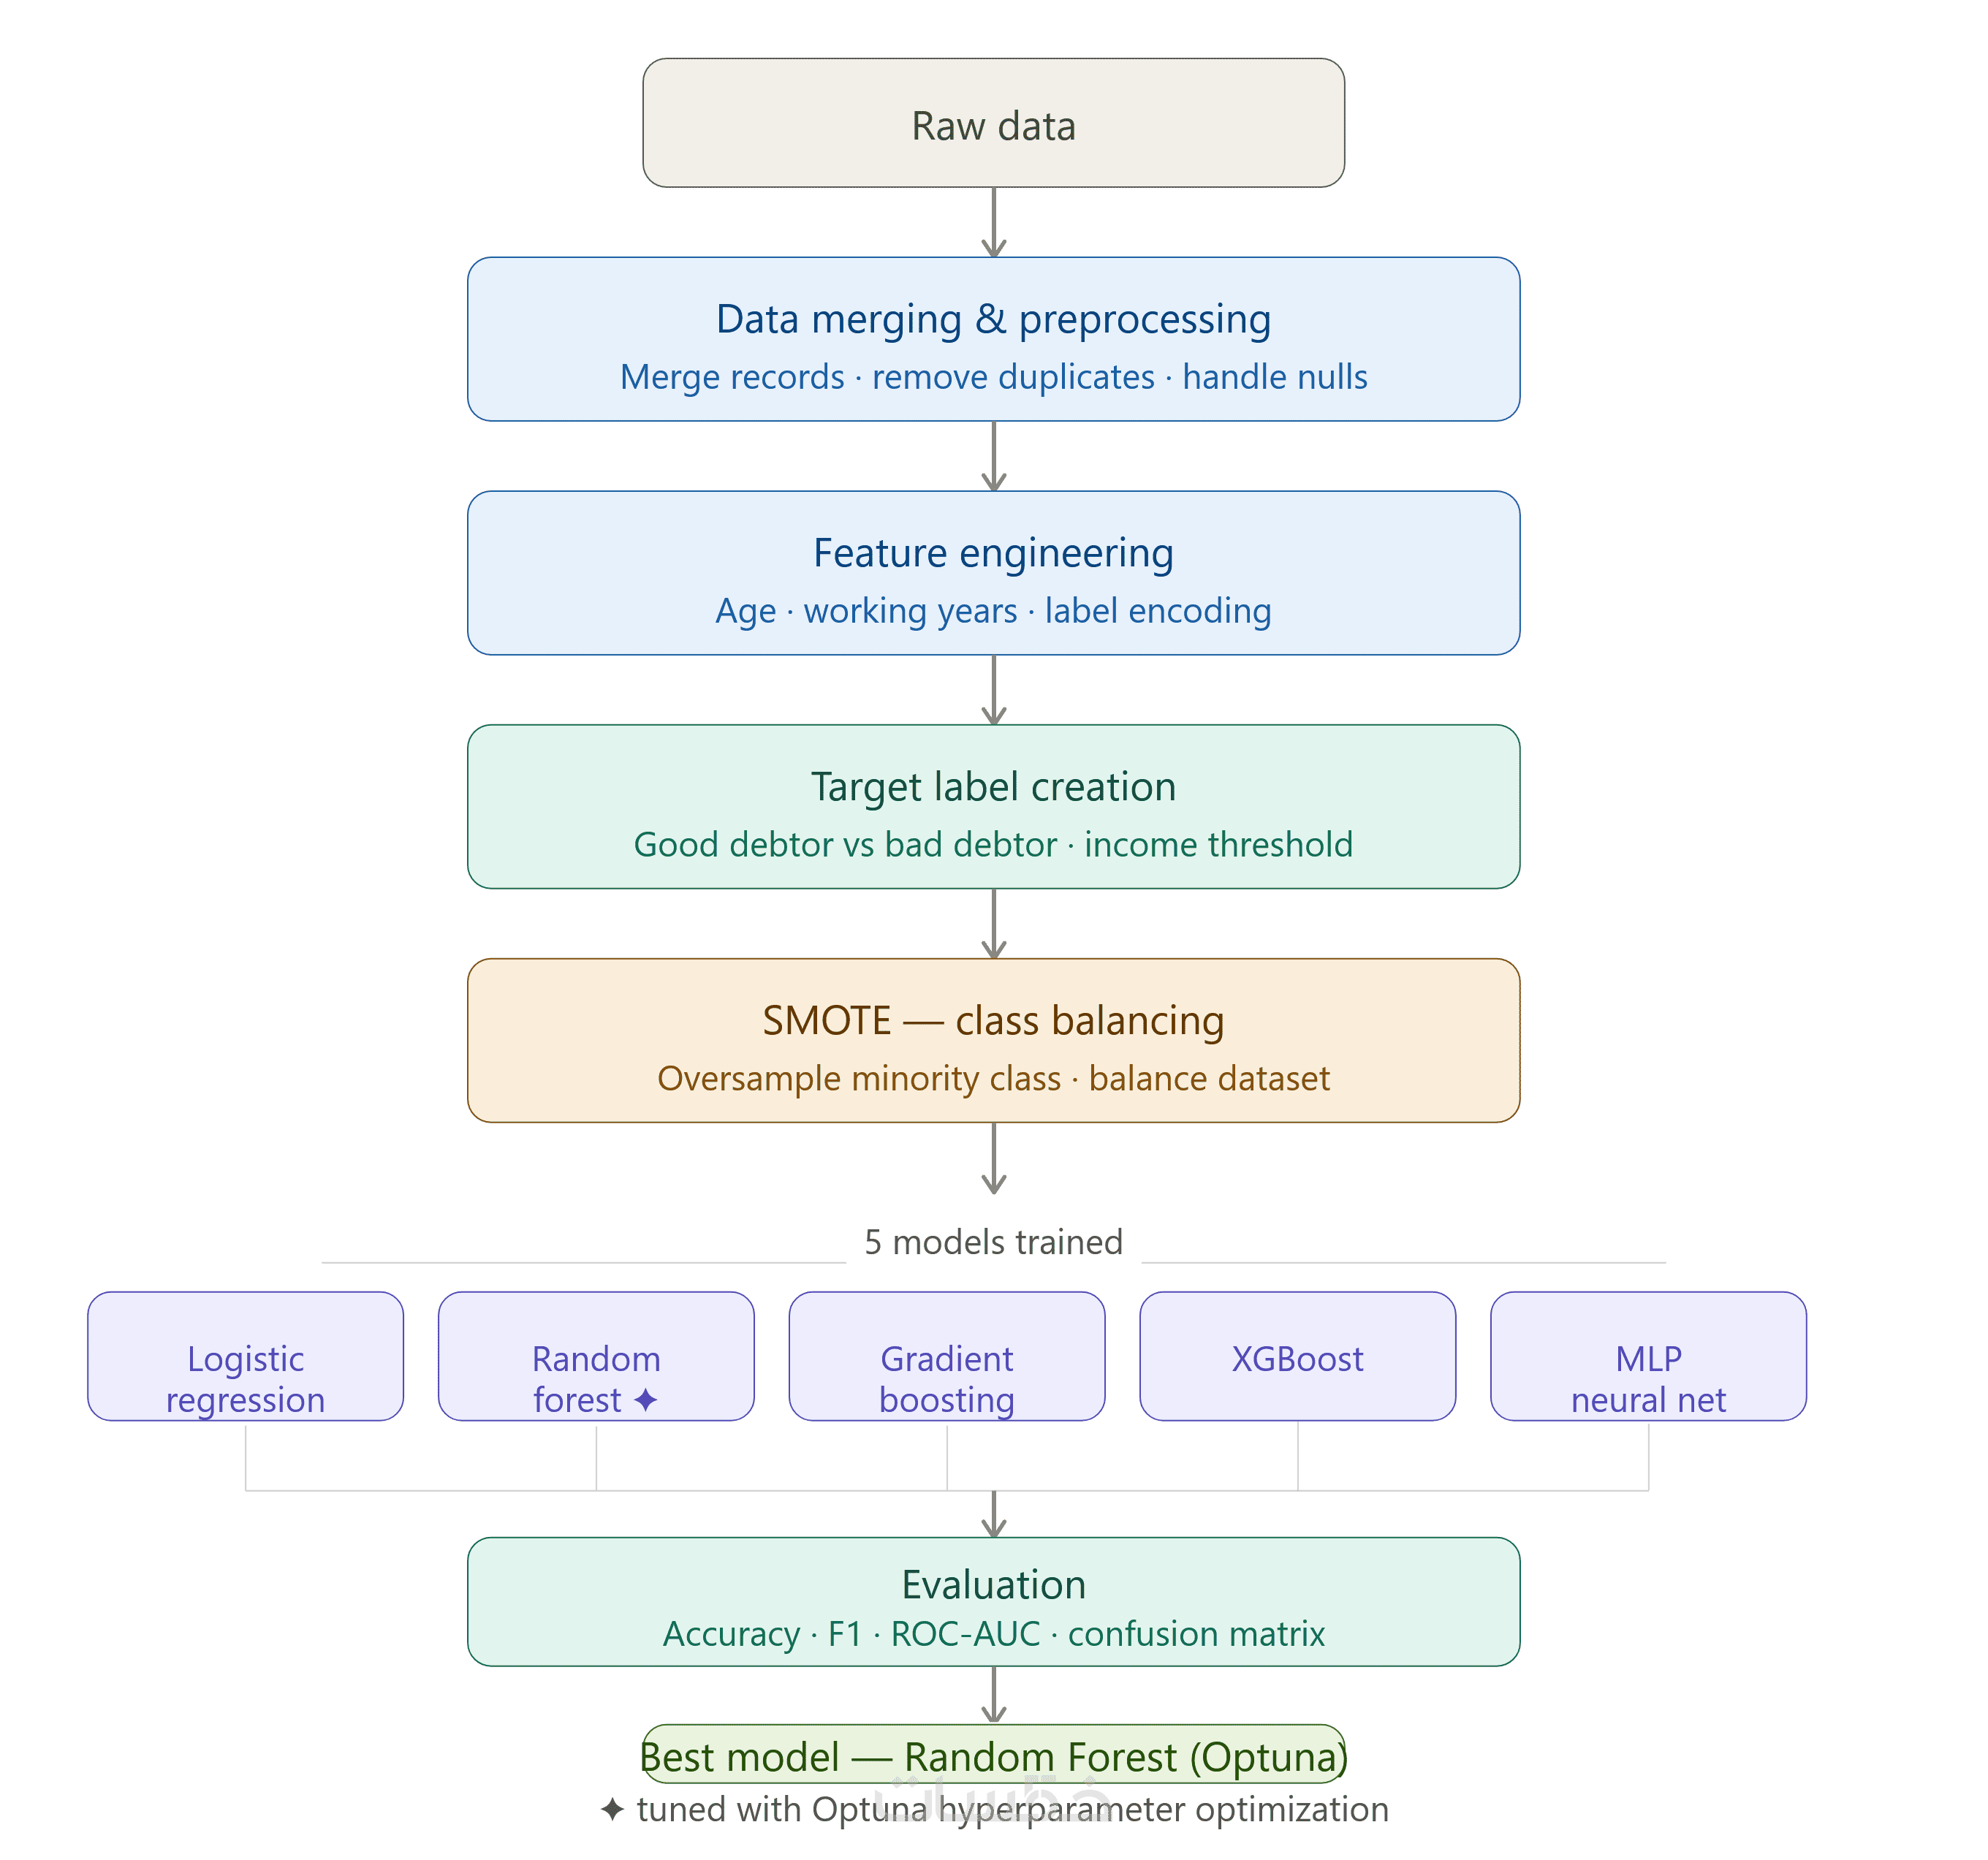
تنفيذ جميع المراحل المذكورة من الاستكشاف حتى تقييم نموذج واحد.
خطوات العمل:
1. استكشاف البيانات: فهم طبيعة البيانات والمميزات المتوفرة.
2. تنظيف البيانات: معالجة القيم المفقودة والتكرارات والأخطاء.
3. التحليل الاستكشافي (EDA): اكتشاف الأنماط والعلاقات بين المتغيرات.
4. هندسة السمات والمعالجة المسبقة: تجهيز البيانات بشكل مناسب للنماذج.
5. تطبيق خوارزميات التعلم غير الخاضع للإشراف: مثل التجميع (Clustering) وتقليل الأبعاد (Dimensionality Reduction).
6. تطبيق خوارزميات التعلم الخاضع للإشراف: تصنيف (Classification) أو انحدار (Regression) – حسب طبيعة البيانات.
7. تقييم النموذج: باستخدام مقاييس أداء مناسبة لضمان جودة النتائج.
مميزات الخدمة
نماذج تنبؤية دقيقة
بناء نماذج Machine Learning و عالية الدقة باستخدام Scikit-Learn .
تحليل بيانات شامل
تنظيف ومعالجة البيانات (Data Cleaning & EDA) واستخراج رؤى واضحة تساعد في اتخاذ القرار.
تصور بياني احترافي
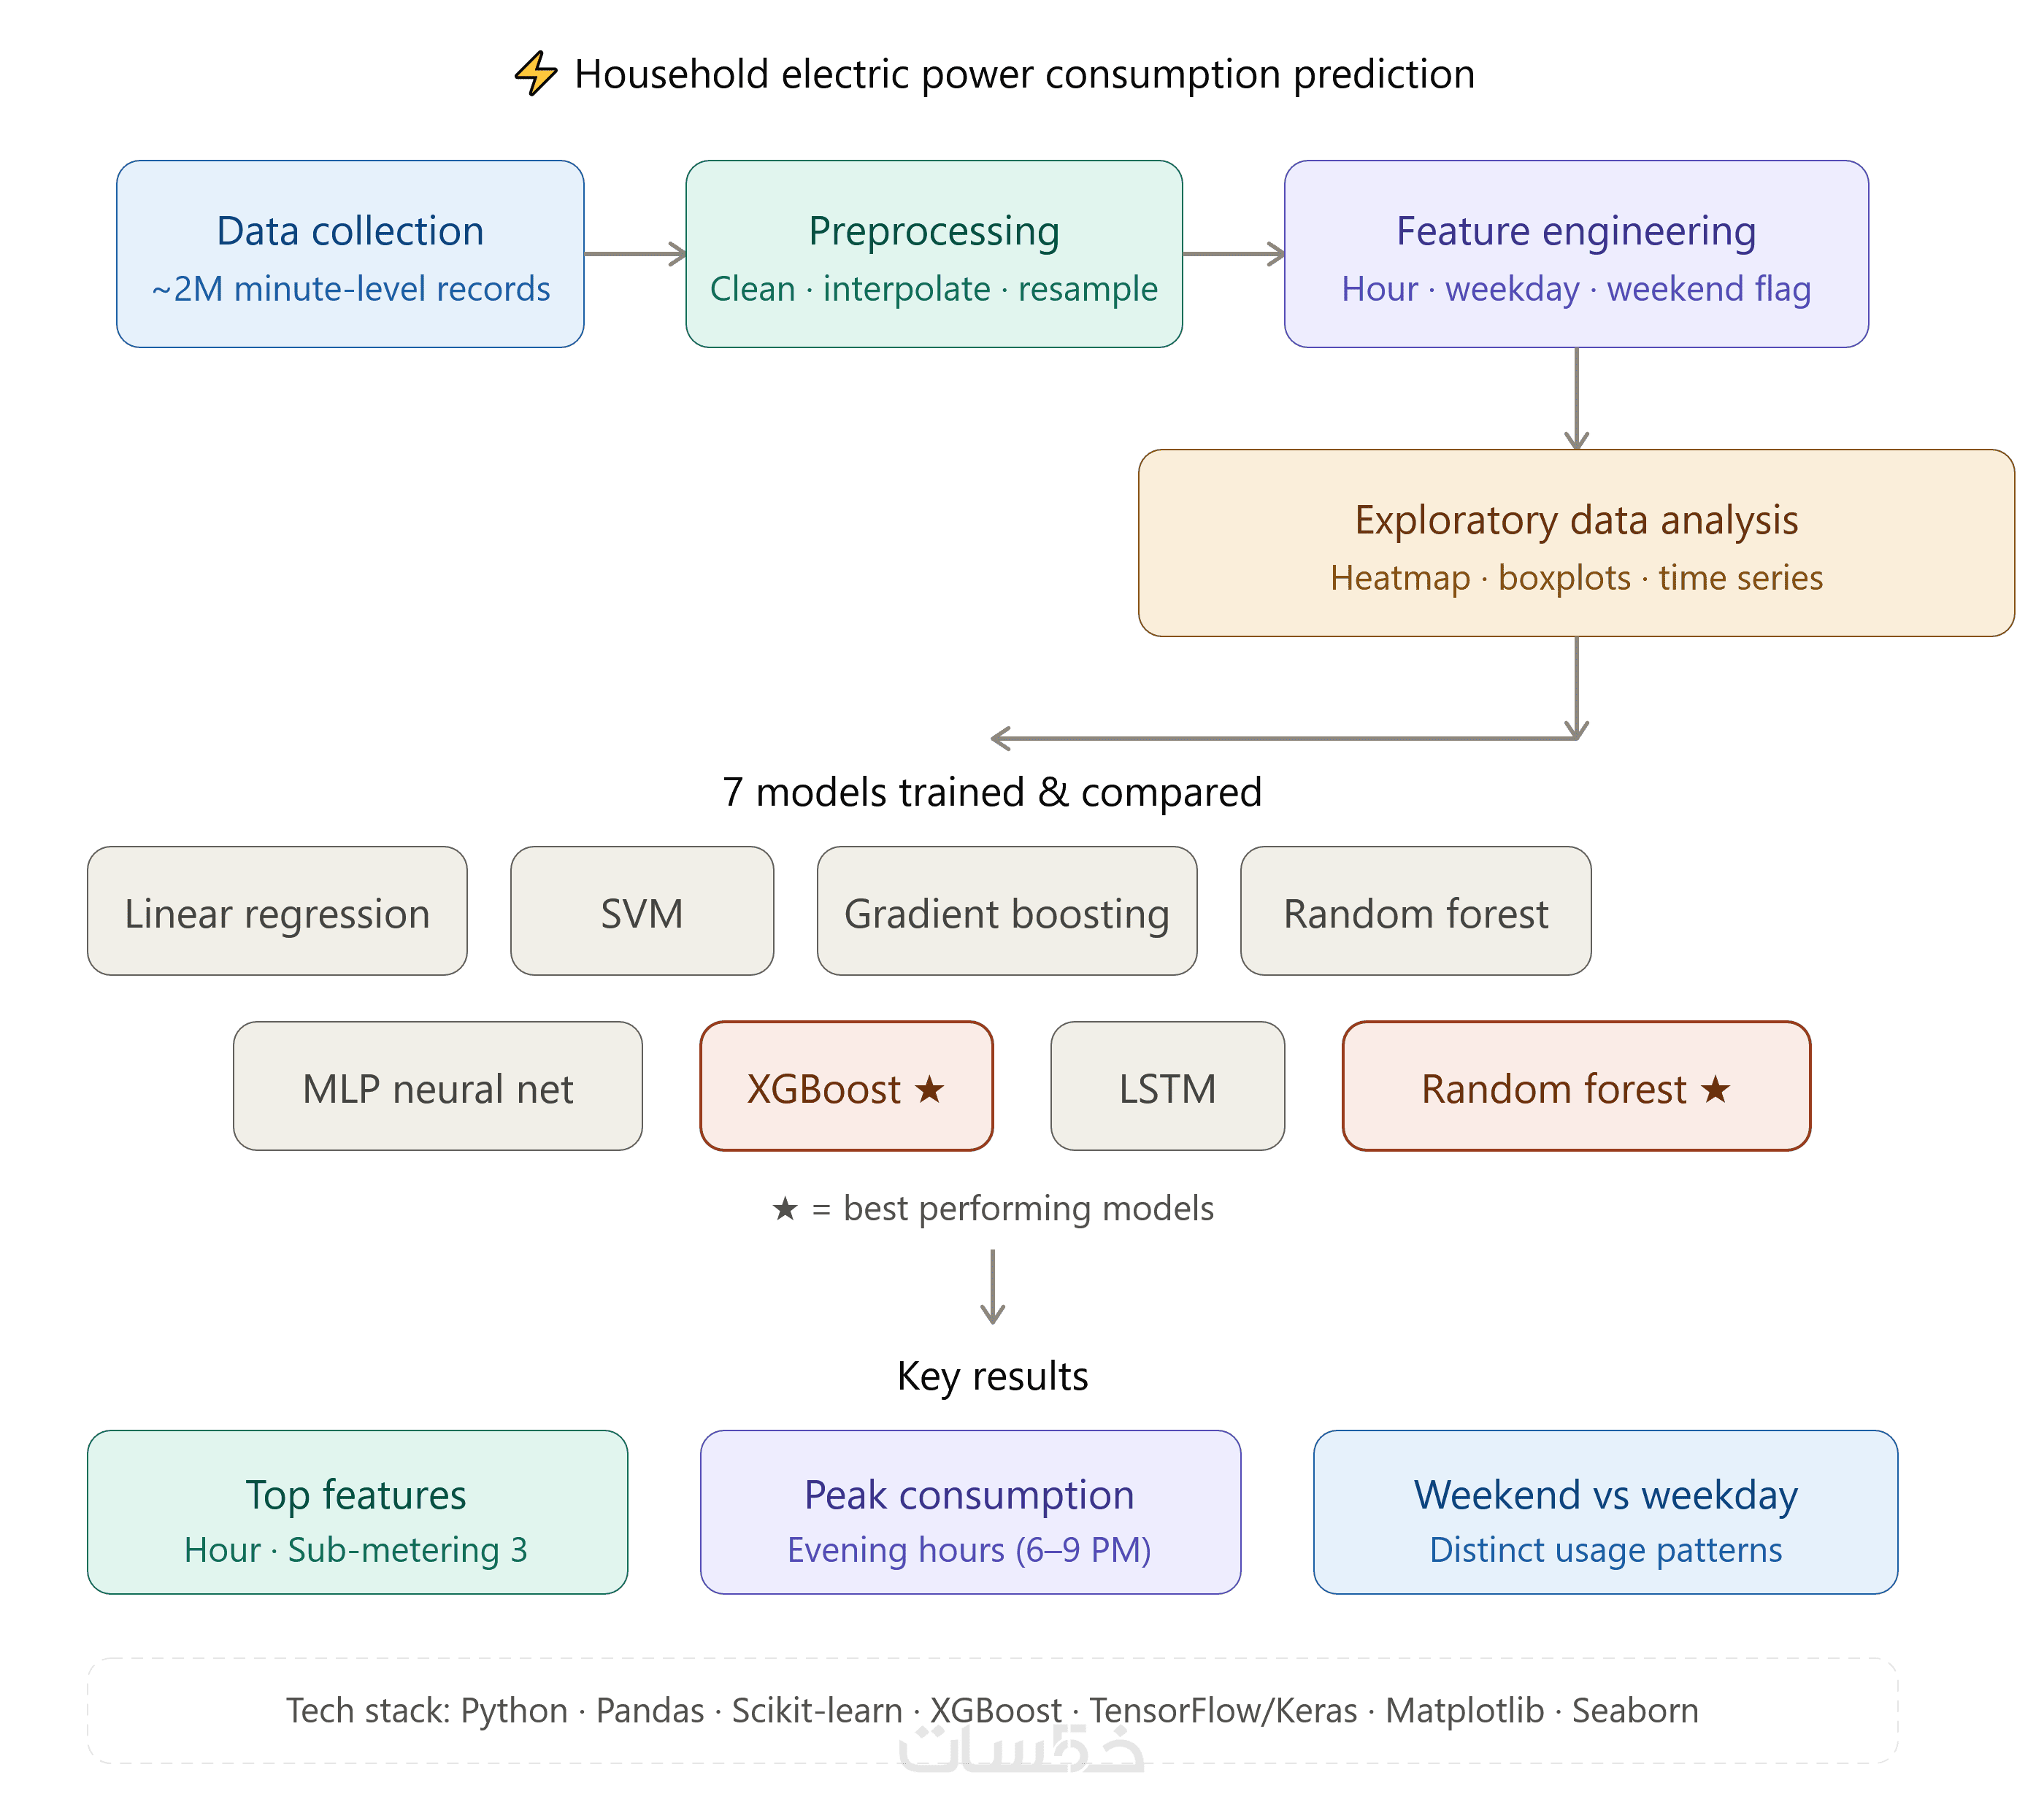
لوحات تحكم وتقارير تفاعلية باستخدام Power BI ومكتبات Python (Matplotlib, Seaborn).
خبرة في مشاريع متنوعة
تجربة عملية في مشاريع تصنيف
٥ توثيق ونتائج مدعومة بالأرقام
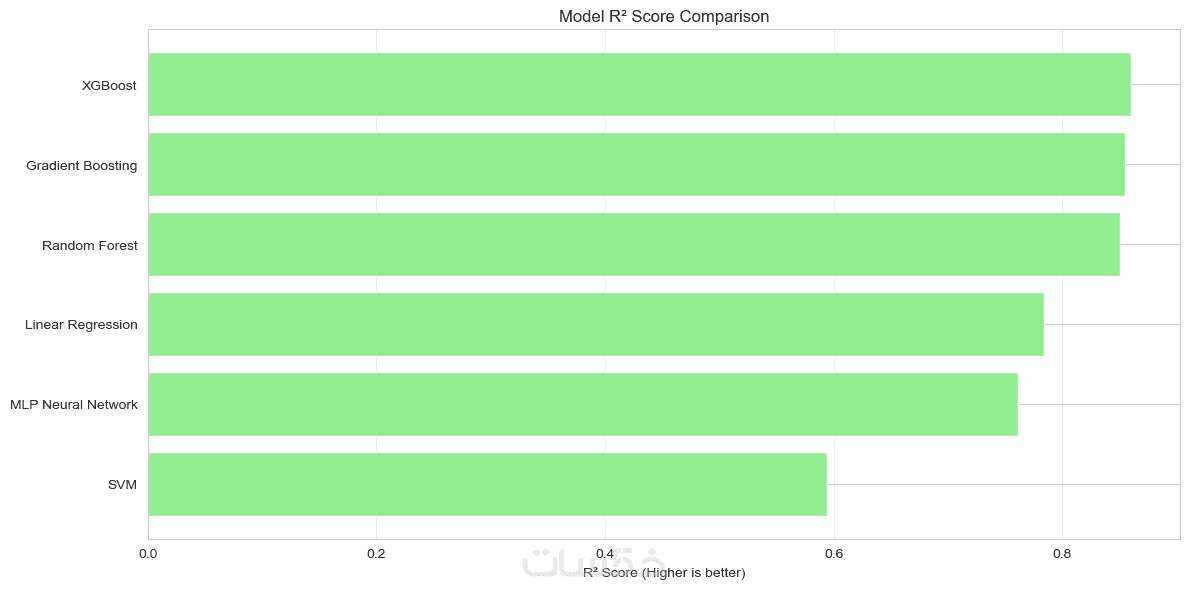
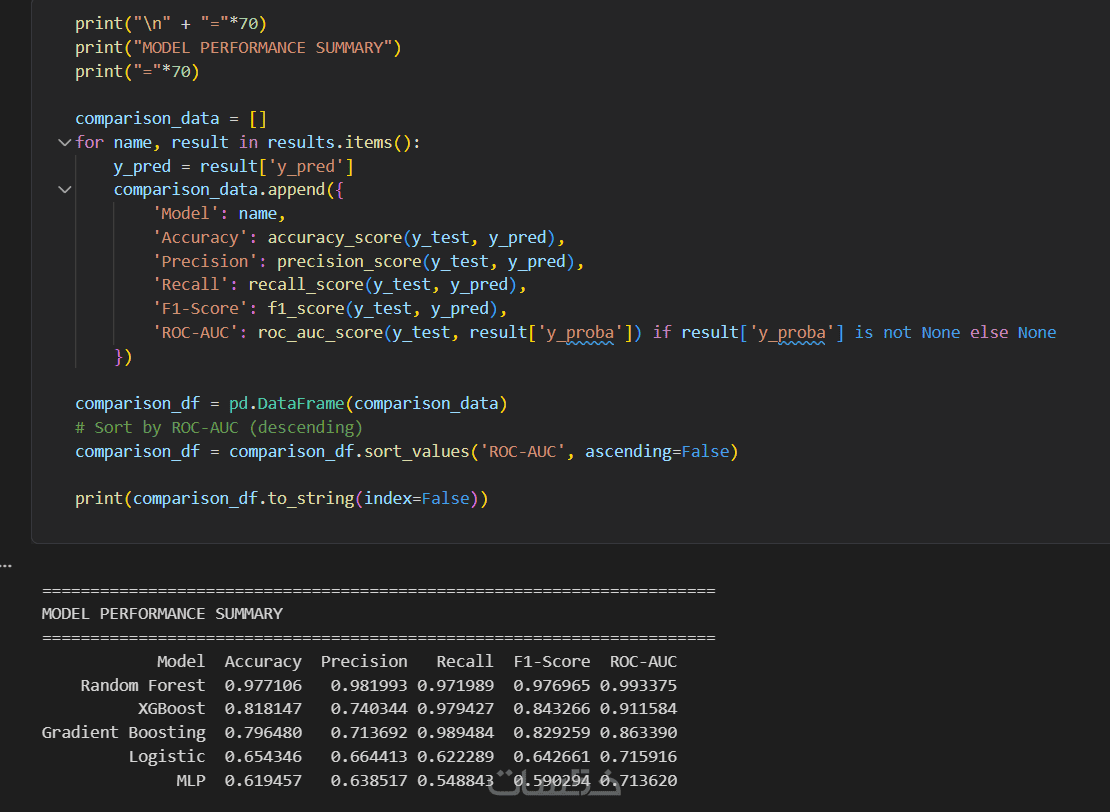
كل نموذج مُقيَّم بمقاييس دقيقة (Accuracy, F1-Score, ROC-AUC) وتقرير واضح بالنتائج.
ما الذي ستستلمه
كود Python كامل ومنظم
سكريبت أو Notebook جاهز يحتوي على كل خطوات المعالجة والنمذجة.
تقرير نتائج مفصل
شرح للمنهجية، النتائج، والرسوم البيانية الداعمة (PDF أو Power BI).
النموذج المدرَّب (Trained Model)
ملف النموذج جاهز للاستخدام أو النشر (Deployment).
تعديلين مجانيين
لضبط النموذج أو التقرير حسب ملاحظاتك بعد التسليم.
شرح فيديو أو مكالمة قصيرة
توضيح لكيفية استخدام المخرجات وفهم النتائج.
كلمات مفتاحية
خدمات قد تنال إعجابك


طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
اضافة Dashbord by using Power BI احترافى يعرض النتائج
15.00
|
|
تدريب و مقارنة 2 - 3 نماذج models (random forest , XGBOOST , Logistic Regression
15.00
|
|
تحسين نموذج و شرح مفصلا عن طريق google meet
20.00
|


طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
اضافة Dashbord by using Power BI احترافى يعرض النتائج
15.00
|
|
تدريب و مقارنة 2 - 3 نماذج models (random forest , XGBOOST , Logistic Regression
15.00
|
|
تحسين نموذج و شرح مفصلا عن طريق google meet
20.00
|
خدمات قد تنال إعجابك
كلمات مفتاحية
