تنظيف البيانات وبناء نموذج تعلّم آلي Machine Learning
تنظيف البيانات وبناء نموذج تعلّم آلي Machine Learning
وصف الخدمة
هل لديك بيانات خام وتريد تحويلها إلى قرارات وتنبؤات دقيقة تخدم مشروعك؟
أقدم لك خدمة متكاملة تبدأ من تنظيف البيانات (Data Preprocessing) وحتى بناء وتقييم نماذج التعلم الآلي (Machine Learning) المخصصة لهدفك.
تنظيف ومعالجة البيانات: معالجة القيم المفقودة، المكررة، القيم الشاذة (Outliers)، والترميز (Encoding & Scaling).
نماذج التصنيف والتنبؤ (Supervised): بناء نماذج مثل Random Forest وXGBoost وRegression للتنبؤ بالمبيعات أو سلوك العملاء.
التجميع (Unsupervised): تقسيم البيانات إلى فئات متجانسة باستخدام K-Means.
مخرجات الخدمة الأساسية:
معالجة ملف بيانات واحد حتى 10,000 سطر و12 عموداً مع تحليل استكشافي (EDA).
تدريب نموذج آلي واحد وتحديد دقته بمقاييس قياسية.
ميزات إضافية شاملة:
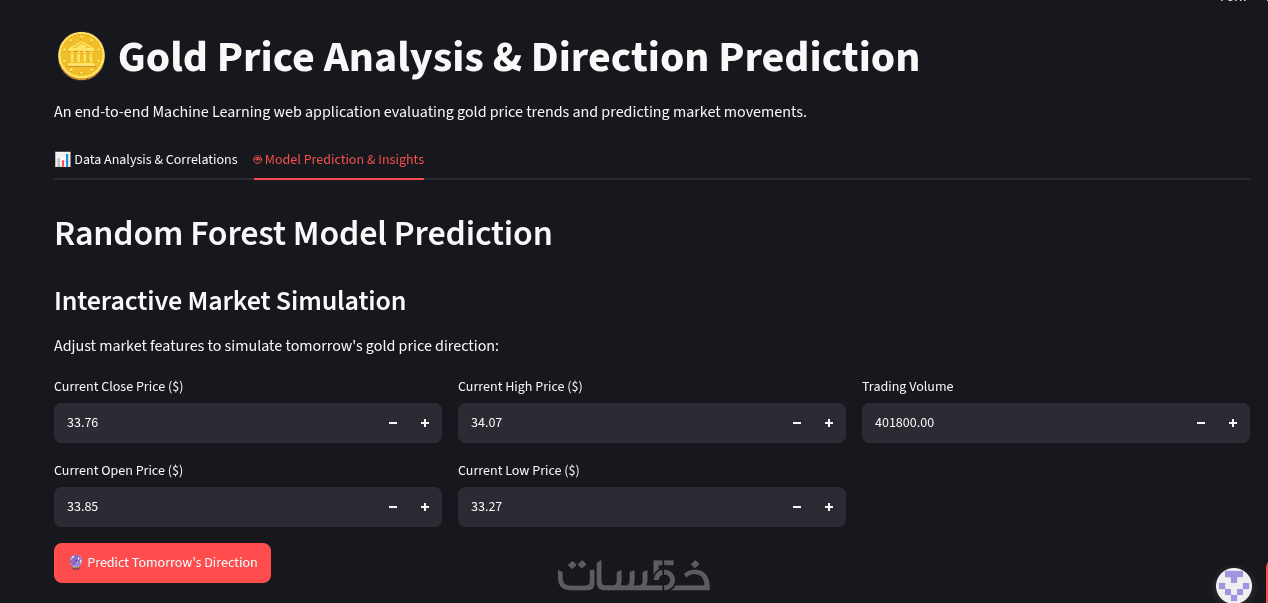
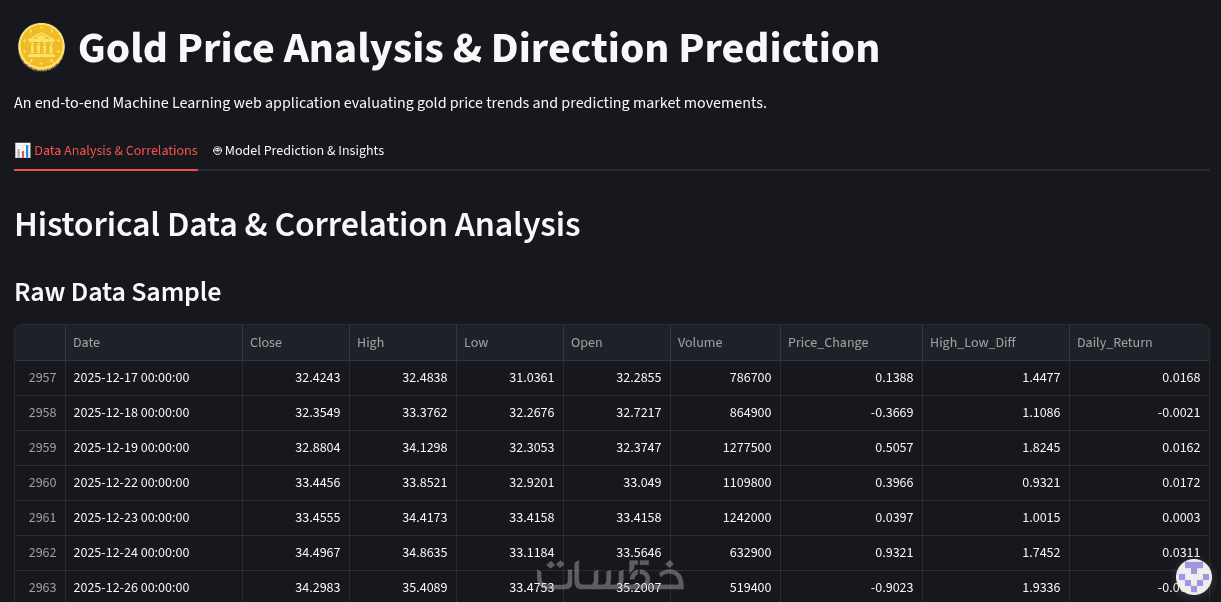
بناء واجهة ويب تفاعلية (Streamlit Web App) لتجربة التنبؤ مباشرة، مع تصدير النموذج بصيغة (.joblib / .pkl) ليكون جاهزاً للربط البرمجي.
مميزات الخدمة
أولوية جودة البيانات
لا نكتفي بتركيب النموذج مباشرة؛ بل نضمن نماء ودقة البيانات أولاً لأن 80% من نجاح النموذج يعتمد على نظافة مدخلاته.
كود نظيف وموثق
تم كتابة الكود بأسلوب منظم وشرح للمراحل (Clean Code & Comments) لسهولة تطويره أو ربطه بأي نظام لاحقاً.
اختيار الخوارزمية الأنسب
نعتمد على الخوارزميات الأكثر استقراراً ودقة بحسب نوع المشكلة (مثل Random Forest للتغلب على Overfitting).
دعم وفهم للأرقام
شرح مخرجات النموذج للعميل بدون تعقيد برمجي، مع رسم بياني يوضح أهم الميزات (Feature Importance).
ما الذي ستستلمه
ملف Jupyter Notebook
ملف Jupyter Notebook احترافي ومُنظّم ومكتوب بلغة Python.
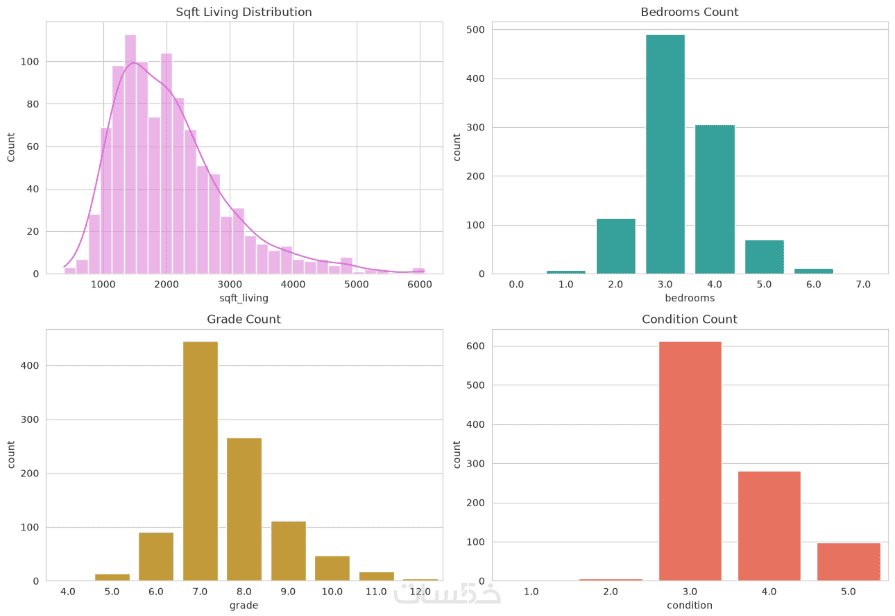
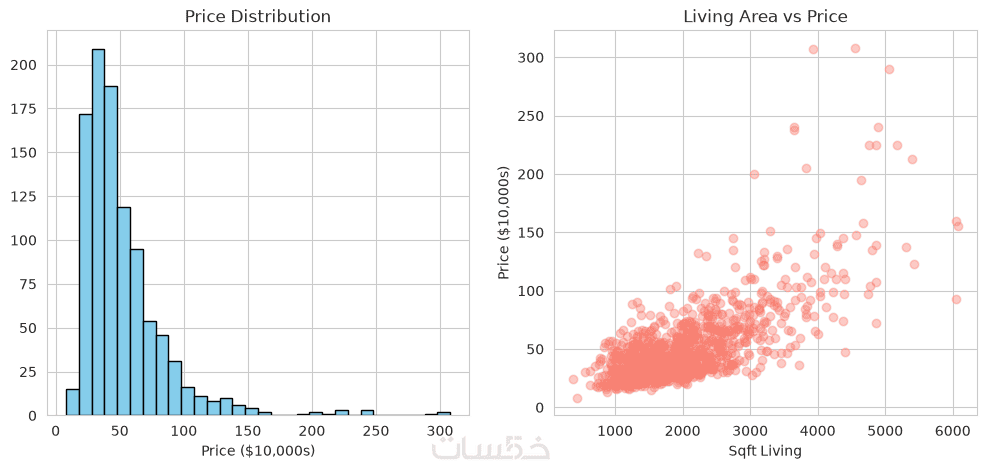
ويحوي جميع الرسومات البيانية المطلوبة.
تقرير
تقرير مختصر (PDF) يوضح النتائج وأداء النموذج بلغة سهلة ومباشرة.
واجهة تفاعلية (Streamlit)
واجهة تفاعلية بسيطة (Streamlit Web App): لتجربة التنبؤ بشكل مباشر من المتصفح (تطوير ممتع ومبهر جداً للعملاء).
صيغة (.joblib / .pkl)
حفظ النموذج بصيغة (.joblib / .pkl): جاهز للاستخدام والتكامل مباشرة مع أي تطبيق.
كلمات مفتاحية
خدمات قد تنال إعجابك


طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
زيادة حجم البيانات الى 50 الف سطر و 25 عمود
5.00
|
|
Hyper-parameter Tuning: اجراء تجارب واختبارات للوصول لاعلى دقة ممكنة
10.00
|


طلب الخدمة
سعر الخدمة
$5.00
تطويرات اختيارية
زيادة حجم البيانات الى 50 الف سطر و 25 عمود
5.00
|
|
Hyper-parameter Tuning: اجراء تجارب واختبارات للوصول لاعلى دقة ممكنة
10.00
|
خدمات قد تنال إعجابك
كلمات مفتاحية
